버튼 한 번으로 서비스 로봇의 실패를 바로잡는 실시간 재계획
Real-Time Service Robot Replanning via Simple Button Interaction for Improved Task Success and User Experience
arXiv:2609.17541v1 본문 전체의 한국어 번역입니다. 그림 8개와 표 1개를 모두 포함합니다. 그림 안의 영어 표기와 참고문헌 서지정보는 원문을 보존하고 그림 설명을 한국어로 덧붙였습니다. 원저자의 검토를 받은 공식 번역은 아닙니다.
Ryo Terashima*, Yuga Yano*, Koshun Arimura, Hakaru Tamukoh
일본 규슈공업대학교. Hakaru Tamukoh는 뉴로모픽 AI 하드웨어 연구센터에도 소속되어 있습니다. * 공동 제1저자.
초록
서비스 로봇은 실제 환경에서 예상하지 못한 지시에 대응해야 한다. 그러나 로봇은 작업 중 발생하는 모든 실패와 예외를 탐지할 수 없다. 이 문제를 해결하기 위해 사람의 피드백에 따라 로봇의 행동을 수정하는 실시간 피드백 기능을 제안한다. 사용자는 로봇이 올바르게 행동하지 않을 때 태블릿의 버튼 하나를 눌러 직관적으로 피드백을 보낸다. 로봇은 이 피드백을 이용해 실패를 추론하고 적절한 행동을 다시 계획하여 작업을 완료한다.
“간단한 상호작용은 부정적인 사용자 경험을 유발하지 않는다”는 가설을 검증하기 위해 피드백 기능을 사용한 실험과 사용하지 않은 실험을 수행했다. 모든 설문 응답은 5점 리커트 척도로 평가했다. 기능을 추가한 뒤 “로봇의 행동이 예상 밖이라고 느꼈는가?”라는 문항은 0.5점, “로봇의 행동에 때때로 불안을 느꼈는가?”라는 문항은 0.9점 개선됐다. 결과는 연구 가설을 지지하며, 실시간 피드백이 작업 성공과 사용자 경험을 함께 개선할 수 있음을 나타낸다.
I. 서론
최근 서비스 로봇은 식당, 병원, 가정 등 여러 환경에서 활용되고 있다[13,23,5,1,22]. 실제 환경에서는 예상하지 못한 지시를 받는 일이 많다. 따라서 지시를 이해하고 상황에 맞게 유연하게 대응해야 한다. 이를 위해 대규모 언어 모델(LLM)에 기반한 로봇 작업 계획 방법들이 제안됐다[11,19,10,21]. SayCan[7]은 LLM이 자연어 지시를 이해하고 상황에 적합한 행동을 결정하는 체계다. 한 가지 행동으로 해결되는 과제에서는 성공률이 87%지만, 여러 행동을 요구하는 과제에서는 50% 미만으로 내려간다.
복잡한 과제의 성공률을 높이려면 로봇이 실패를 탐지하고 작업을 다시 계획해야 한다. 불확실성 예측과 자기 복구 프롬프팅을 이용한 서비스 로봇의 재계획 방법이 제안된 이유다[16,18]. 이러한 방법은 작업 중 문제가 있음을 로봇이 알아차리면 사람에게 도움을 청하고 적절한 행동을 선택한다. 따라서 도움을 요청하기 전에 로봇이 실패를 발견할 수 있어야 한다. 하지만 물체 인식이나 음성 인식 오류처럼 로봇이 알아차리지 못하는 실패도 있다. 이때 사람이 개입해 행동을 바로잡는 기능이 필요하다.
한편 선행연구는 상호작용 증가와 사용자 부담 사이의 밀접한 관계를 보고했다. 상호작용에 소요되는 시간이 늘면 사람–로봇 팀의 효율이 낮아지며[12], 과제 중 개입은 수행 능력을 떨어뜨리고 좌절감과 불안을 높일 수 있다[3,9]. 최근 일부 연구가 상호작용을 최소화하도록 설계한 배경이다[16,4]. 그러나 로봇은 모든 실패를 자율적으로 발견할 수 없다. “사용자 부담 때문에 개입을 줄여야 한다”는 설계 방향과 “완전한 자율성을 달성할 수 없다”는 현실 사이에 간극이 존재한다.
선행연구[12,3,9]에 따르면 부담은 빈도뿐 아니라 상호작용 방식에도 달려 있다. 본 연구의 가설은 “간단한 상호작용은 부정적인 사용자 경험을 유발하지 않는다”이다. 문제를 개입 자체보다 개입 방식이 사용자에게 지우는 부담으로 바라본다.
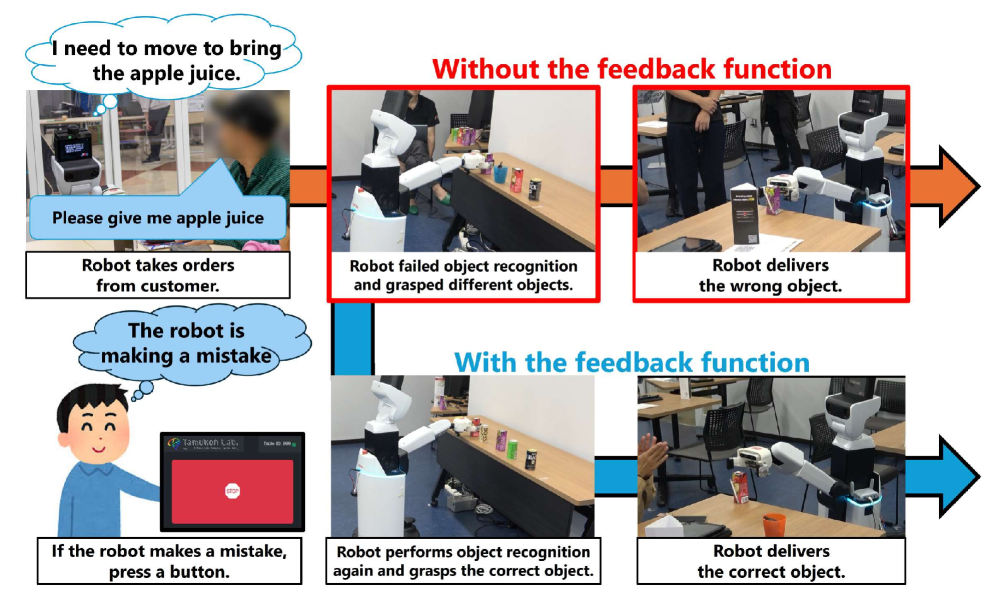
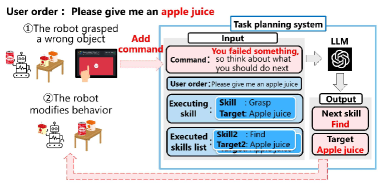
이에 로봇이 작업에 실패했을 때 사용자가 한 번의 조작으로 쉽게 개입하고 로봇 행동을 자연스럽게 수정하는 실시간 피드백 시스템을 제안한다. 실패 원인 추론을 LLM에 맡기므로 사용자는 무엇이 잘못됐는지 찾아내거나 말로 설명할 필요가 없다. 그림 1은 개요를 보여준다. 제안 방법은 SayCan을 바탕으로 작업을 순차적으로 추론한다. 실행 중 피드백을 받으면 실패 당시 상황과 이전에 수행한 스킬을 입력받아 상황에 적합한 행동을 다시 계획하여 성공률을 높인다.
주문이 바뀌거나 예상하지 못한 주문이 들어오는 모의 식당 환경에서 피드백 기능의 유무를 비교했다. 두 실험 후 동일한 인간–로봇 상호작용(HRI) 설문을 실시하고, 작업 성공률과 설문 결과로 효과를 검증했다. 실시간 피드백은 성공률을 높였으며, 주관적 평가에서는 불안과 로봇에 개입하고 싶다는 요구가 감소했다. 주요 기여는 다음 두 가지다. 첫째, 한 번의 조작으로 작업 중 로봇 행동을 수정할 수 있는 실시간 피드백 시스템을 제안한다. 둘째, 실험과 HRI 설문으로 개입 조작의 단순화가 사용자 부담을 줄일 수 있음을 보여준다.
II. 관련 연구
A. LLM 기반 작업 계획
LLM 기반 작업 계획은 자연어 지시를 해석하고 상황에 적합한 행동을 선택하게 한다[7,24]. SayCan[7]은 자연어 지시에 따라 사전 정의된 스킬을 조합해 행동을 추론한다. Yano 등의 시스템[24]은 실제 환경의 HRI를 위해 LLM의 작업 이해와 동적 지도를 활용한 반응 생성을 통합했다. 그러나 단일 단계 과제의 성공률이 높더라도 여러 단계에서는 불확실성과 실패가 증가한다. 단일 단계는 잡기 같은 한 가지 스킬을 사용하는 과제이고, 다단계는 잡기·이동·놓기처럼 여러 스킬을 이어 실행하는 과제다.
B. 로봇 작업의 실패 처리
작업의 불확실성과 실패에 대응하기 위해 예방과 복구 접근이 제안됐다[16,18]. Ren 등의 KnowNo[16]는 컨포멀 예측으로 LLM[2] 계획기의 불확실성을 통계적으로 다루고, 불확실성이 높으면 사람의 도움을 요청한다. 자연어 지시를 받으면 여러 행동 후보를 생성하고 정해진 신뢰 수준 이상으로 정답 행동을 포함하는 예측 집합을 만든다. 후보가 하나뿐이면 실행하고 여러 개면 도움을 청한다.
Shirasaka 등의 Self-Recovery Prompting[18]은 실패나 정보 부족을 탐지했을 때 다시 계획하고 사람에게 도움을 요청하도록 한다. GPT-4[14]의 계획 생성, Whisper[15]의 음성 인식, Detic[25]의 물체 탐지 등 여러 기반 모델을 통합한다. 이 접근들은 로봇이 불확실성과 실패를 직접 알아차리고 도움을 요청한다. 하지만 실제 환경의 의미 오해나 물체 인식 오류 중에는 로봇이 스스로 탐지하지 못하는 경우가 있다. 자신의 실패를 인식하지 못하면 도움을 청할 수도 없다.
C. 상호작용에 따른 사용자 부담
사람과 시스템이 협력할 때 상호작용은 사용자 부담의 관점에서도 논의된다. Olsen 등[12]은 로봇과 상호작용할 때 소모되는 사용자의 주의를 정식화하여, 주의 자원이 팀 효율을 제한함을 보였다. 부담은 횟수뿐 아니라 개입 시점에도 달려 있다. Bailey 등[3]은 컴퓨터 과제의 자연스러운 중단 지점 또는 수행 도중에 시스템이 끼어드는 통제 실험을 했다. 수행 도중 중단은 과제 완료 시간, 오류율, 불쾌감과 불안을 유의하게 높였다.
Mannem 등[9]은 사람–로봇 협력에서 질문의 시점·내용·근접성을 바꾸어 개입의 비용을 조사했다. 세 요인 모두 과제 수행에 영향을 주었고, 끼어드는 로봇은 더 낮은 사용성 평가를 받았다. 로봇이 먼저 시작하는 질문은 수행 능력뿐 아니라 로봇에 대한 정서적 평가에도 부정적인 영향을 줄 수 있다. 이런 배경으로 최근 연구는 사용자 상호작용을 최소화하는 방침을 자주 채택했다[16,4].
III. 제안 방법
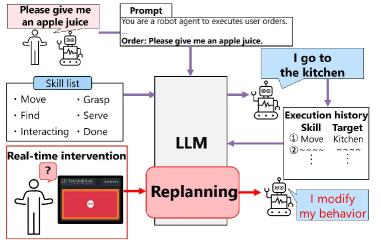
본 연구는 사용자 개입 부담을 최소화하면서도 로봇이 스스로 탐지하지 못한 실패에서 회복하도록 한다. 사람이 직관적이고 간단하게 상호작용하는 실시간 피드백 기능을 제안한다. 그림 2처럼 로봇이 실패를 발견하지 못했을 때 사용자의 피드백을 받아 행동과 작업을 수정한다. 상호작용을 줄이기 위해 한 번의 버튼 누르기로 피드백을 보내도록 설계했다.
A. 작업 계획
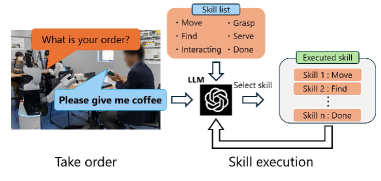
그림 3은 작업 계획의 흐름이다. 제안 시스템은 순차 실행으로 작업 도중 갑작스러운 변경에도 대응한다. Yano 등의 기존 시스템은 사용자 지시를 바탕으로 사전 정의된 과제 중 적절한 과제를 예측하고 스킬을 실행하지만, 작업 중 실패에는 대응할 수 없다. 본 연구는 실행 방법을 개선하고 SayCan[7] 기반 순차 실행을 적용했다.
스킬 목록과 사용자 지시를 GPT-4o[6]에 입력하면 우선 실행할 스킬과 대상 물체 또는 위치를 추론한다. 스킬을 실행한 뒤에는 이전에 실행한 스킬과 대상 정보를 이용해 다음 스킬과 대상을 추론한다. 더 실행할 스킬이 없으면 추론 결과가 “Done”이 되어 작업 계획을 마친다.
B. 실시간 피드백 기능
핵심 설계는 실패 원인 분석을 LLM에 맡기는 것이다. 사용자는 문제를 찾아내거나 로봇에게 설명할 필요가 없다. 이를 통해 버튼 하나의 인터페이스로 신체적·인지적 부담을 최소화한다. 그림 4처럼 태블릿의 버튼을 누르면 쉽게 피드백을 보낼 수 있다. 어느 작업 단계에서 누르든 버튼은 “무언가 실패했다”는 정보만 전달한다.
그림 5는 피드백 시 작업 계획 시스템에 보내는 프롬프트의 예다. 실행한 스킬 목록과 사용자의 주문을 포함해 로봇이 상황을 파악하게 한다. 이후 “무엇을 실패했는가?”와 “행동을 어떻게 수정해야 하는가?”를 추론하고 이동·잡기 등의 스킬과 대상 물체를 다시 검토한다. 예를 들어 잘못된 음료를 집을 때 피드백을 받으면 음료가 잘못됐다고 판단하고, 올바른 음료를 찾아 집도록 작업을 바꾼다.
IV. 실험
식당의 인력 부족으로 종업원 업무를 돕는 서비스 로봇의 필요성이 커지고 있다. 주문 변경, 예상하지 못한 요청, 실제 환경 변화에 유연하게 대응해야 하므로 식당 업무는 어렵다. 이에 주문 이해, 음식 제공, 테이블 정리와 사용자 상호작용을 포함한 종업원 업무에 주목했다.
실내 서비스 로봇을 대상으로 하는 RoboCup@Home[17]을 참고해 업무를 설계하고, “간단한 상호작용은 부정적인 사용자 경험을 유발하지 않는다”는 가설을 사용자 실험으로 검증했다. 여기서 부정적 경험은 불안감 또는 예상 밖 행동 등으로 로봇에 나쁜 인상을 갖는 것을 뜻한다. 동일한 조건에서 피드백 유무에 따른 성공률과 5점 리커트 척도[8] 설문을 비교했다.
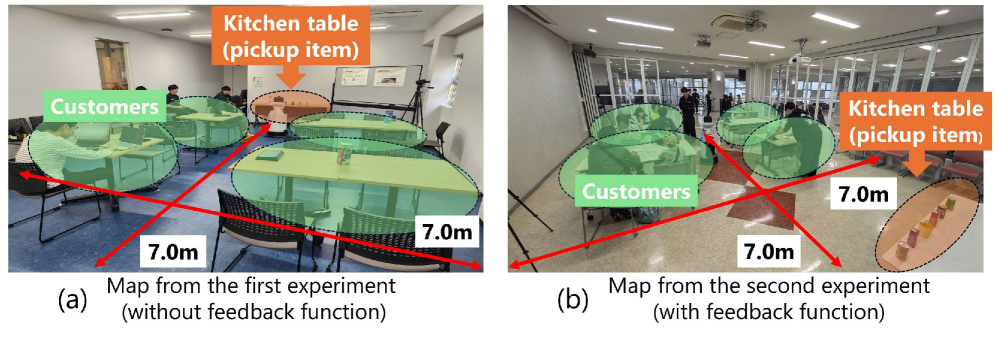
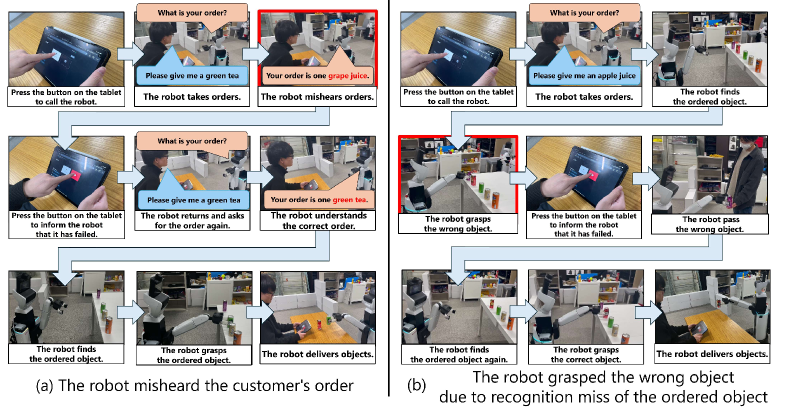
그림 6은 두 실험 환경, 그림 7은 실제 실험 시나리오다. 공간 크기, 책상 배치, 물체 등 조건을 같게 하고 두 실험에 서로 다른 참가자를 초대했다. 한 번의 실험에 참가자들이 집단으로 참여했으므로 참가자 수가 시행 횟수보다 많다. 로봇은 마이크와 화면을 갖추고 사람과 상호작용할 수 있는 이동형 매니퓰레이터 Human Support Robot[20]을 사용했다.
A. 피드백 기능이 없는 실험
표 1은 성공률이다. 사용자 91명이 참여했고 주문받기와 서빙을 38회 수행했다. 요청한 물건을 제대로 전달한 횟수는 21회였다. 주요 실패 원인은 주문을 잘못 듣는 음성 인식 오류와 다른 물체를 목표로 착각하는 물체 인식 오류였다.
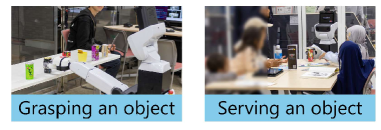
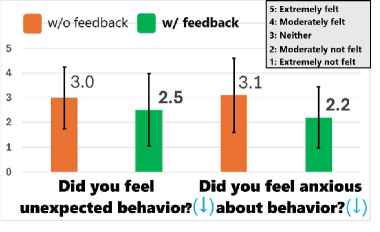
그림 8은 설문 결과다. HRI 설문에는 36명이 응답했으며 학생 10명, 직장인 26명이었다. “로봇의 행동이 예상 밖이라고 느꼈는가?”의 전체 평균은 3.0점이었다. 로봇이 때때로 실패해도 사용자가 추가로 지시하거나 실패를 지적할 수 없어 불편함을 느낀다는 결과다. “로봇의 행동에 때때로 불안을 느꼈는가?”는 평균 3.1점이었다. 피드백 기능이 없으면 행동을 충분히 이해하지 못하거나 편안하게 느끼지 못함을 보여준다.
| 조건 | 성공 / 전체 시행 | 성공률 |
|---|---|---|
| 피드백 기능 없음 | 21 / 38 | 55% |
| 피드백 기능 있음 | 43 / 50 | 86% |
피드백 없는 실험에서는 추가 지시 기능의 필요성도 물었다. “로봇에게 추가 지시를 하거나 실패를 지적하고 싶었는가?”의 평균은 4.5점이었다. 예상 밖의 행동은 사용성을 낮추며, 이 문제를 해결하는 데 피드백 기능이 중요하다는 결과다.
B. 피드백 기능이 있는 실험
사용자 133명이 참여했고 주문받기와 서빙을 50회 수행했다. 43회 성공했으며 그중 8회는 피드백으로 복구됐다. 나머지 7회는 실패했다. 이는 피드백이 전달되면 로봇이 작업을 재검토하고 수정할 수 있음을 보여준다. HRI 설문에는 학생 16명, 직장인 20명 등 36명이 응답했다.
“로봇의 행동이 예상 밖이라고 느꼈는가?”는 평균 2.5점으로 첫 실험보다 0.5점 개선됐다. 기능 도입 후 로봇이 의도대로 행동한다고 느낀 응답자가 더 많아졌음을 나타낸다. “로봇의 행동에 때때로 불안을 느꼈는가?”는 평균 2.2점으로 0.9점 개선돼 불안이 낮아졌다. 이 결과는 연구 가설을 지지한다.
피드백으로 상호작용은 늘었지만 사용자는 불안 감소와 더 큰 로봇 개입 의향을 보고했다. 이는 상호작용 부담이 개입 방식의 설계에 달려 있으며, 한 번의 조작으로 사용자가 먼저 시작하는 방식이 사용자 경험을 개선할 수 있음을 시사한다. 어린이를 포함한 모든 연령대에서 피드백 기능을 사용할 수 있음을 확인해 버튼 하나의 인터페이스가 가진 접근성도 보였다.
V. 논의
설문은 실시간 피드백 도입으로 상호작용 빈도가 늘어도 불안은 줄고 로봇에 더 개입하고 싶은 의향은 커졌음을 보여준다. 50회 과제에서 버튼을 누른 것은 8회뿐이며 사용자 90% 이상은 누르지 않았다. 그럼에도 불안 점수가 개선됐다. 행동을 수정할 수단이 존재한다는 사실만으로 불안을 낮출 수 있음을 시사한다. 따라서 상호작용 설계는 과제 결과와 별개로 사용자 경험에 기여한다고 해석하며, 간단한 상호작용이 부정적 경험을 유발하지 않는다는 가설을 지지한다.
성공률은 55%에서 86%로 높아졌다. 로봇이 직접 알아차리지 못하는 실패에 사용자가 먼저 개입하는 것이 효과적이며, II-B절의 한계를 보완할 수 있음을 나타낸다. 연령 집단별로는 성인이 초등학생보다 낮은 불안 점수를 보였다. 가능한 설명은 어린이와 함께 온 성인들이 안전하고 예측 가능한 행동에 더 주의를 기울여 예상 밖 행동에 민감했다는 것이다. 두 집단 모두 개선됐다는 점은 폭넓은 사용자에게 설계가 효과적일 가능성을 시사한다.
로봇이 실패해도 피드백 기능을 사용하지 않는 경향이 일부 사용자, 특히 초등학생에서 관찰됐다. “로봇의 다음 행동을 쉽게 이해할 수 있었는가?”의 평균은 초등학생 3.5점, 성인 4.1점이었다. 어린 사용자는 다음 행동을 예측하고 적절한 개입 시점을 정하기 어려웠을 수 있다.
사용자가 실패를 알아차리지 못해 피드백을 보내지 않은 경우도 있었다. 현재 설계는 실패 탐지를 사용자에게 의존하므로 사용자가 로봇을 지켜볼 수 없을 때 탐지가 어렵다는 한계가 있다. 이번 행사는 참가자가 가까이에서 로봇을 관찰하는 상황이었다. 계속 지켜보지 않는 실제 상황에서는 잡아내는 실패가 적어 성공률도 낮아질 수 있다.
핵심은 현재 상태를 명확히 표시하면 사용자가 로봇을 계속 감시하지 않아도 된다는 점이다. 행동을 즉시 이해할 수 있는 인터페이스는 지속적인 관찰 없이 개입 필요성을 판단하도록 돕는다. 언제 확인하든 상태를 곧바로 이해할 수 있는 인터페이스 설계가 중요한 후속 연구 과제다.
본 연구는 단순한 한 번의 조작이 부담을 줄임을 보였지만 버튼은 개입 설계의 한 예일 뿐이다. 최적의 방식이 있는지 추가 연구가 필요하다. 음성, 몸짓, 시선 감지가 후보이며 각각 사용성, 접근성, 구현 복잡성에서 장단점이 있다.
VI. 결론
서비스 로봇이 행동을 유연하게 수정하도록 실시간 피드백 기능을 제안했다. 식당 종업원 과제에서 기능 유무에 따른 설문과 성공률을 비교한 결과, 음식 서빙 성공률이 55%에서 86%로 증가했다. 설문에서는 로봇 행동을 이해하기 쉬워지고 불안이 감소했다. 간단하고 직관적인 피드백은 선택권을 늘리고 더 자유롭게 상호작용하게 하여 사용성을 높였다. 그 결과 상호작용이 늘었음에도 HRI에 대한 인상은 긍정적이었다.
사용이 간단하고 모든 연령대에서 쉽게 접근할 수 있다는 점이 긍정적 인상의 주요 이유였다. 결과는 “간단한 상호작용은 부정적인 사용자 경험을 유발하지 않는다”는 가설을 지지한다. 향후에는 로봇 행동을 더 쉽게 이해하도록 정보 표현을 개선하고, 음성과 몸짓 등 다른 피드백 방식을 검토하며, 가정처럼 더 유동적이고 복잡한 환경에서 사용자 실험을 수행할 것이다.
연구 지원 및 감사
본 논문은 일본 신에너지·산업기술종합개발기구(NEDO)가 위탁한 JPNP16007 과제의 성과를 바탕으로 한다. JSPS KAKENHI 23H03468 및 23K18495, JST ALCA-Next JPMJAN23F3, JST SPRING JPMJSP2154의 지원을 받았다. 실험을 도운 Hibikino-Musashi@Home 구성원들에게 감사를 표한다.
참고문헌
서지정보는 원문 표기를 보존했습니다.
- [1] A. Acar, B. Türten, and E. Diker (2024) Aspect-based sentiment analysis on social media comments (twitter): the attributes of service robots in the hotel and restaurant industry. Journal of Quality Assurance in Hospitality & Tourism, pp. 1–26. Cited by: §I.
- [2] R. Anil, A. M. Dai, O. Firat, M. Johnson, D. Lepikhin, A. Passos, S. Shakeri, E. Taropa, P. Bailey, Z. Chen, E. Chu, J. H. Clark, L. E. Shafey, Y. Huang, K. Meier-Hellstern, G. Mishra, E. Moreira, M. Omernick, K. Robinson, S. Ruder, Y. Tay, K. Xiao, Y. Xu, Y. Zhang, G. H. Abrego, J. Ahn, J. Austin, P. Barham, J. Botha, J. Bradbury, S. Brahma, K. Brooks, M. Catasta, Y. Cheng, C. Cherry, C. A. Choquette-Choo, A. Chowdhery, C. Crepy, S. Dave, M. Dehghani, S. Dev, J. Devlin, M. Díaz, N. Du, E. Dyer, V. Feinberg, F. Feng, V. Fienber, M. Freitag, X. Garcia, S. Gehrmann, L. Gonzalez, G. Gur-Ari, S. Hand, H. Hashemi, L. Hou, J. Howland, A. Hu, J. Hui, J. Hurwitz, M. Isard, A. Ittycheriah, M. Jagielski, W. Jia, K. Kenealy, M. Krikun, S. Kudugunta, C. Lan, K. Lee, B. Lee, E. Li, M. Li, W. Li, Y. Li, J. Li, H. Lim, H. Lin, Z. Liu, F. Liu, M. Maggioni, A. Mahendru, J. Maynez, V. Misra, M. Moussalem, Z. Nado, J. Nham, E. Ni, A. Nystrom, A. Parrish, M. Pellat, M. Polacek, A. Polozov, R. Pope, S. Qiao, E. Reif, B. Richter, P. Riley, A. C. Ros, A. Roy, B. Saeta, R. Samuel, R. Shelby, A. Slone, D. Smilkov, D. R. So, D. Sohn, S. Tokumine, D. Valter, V. Vasudevan, K. Vodrahalli, X. Wang, P. Wang, Z. Wang, T. Wang, J. Wieting, Y. Wu, K. Xu, Y. Xu, L. Xue, P. Yin, J. Yu, Q. Zhang, S. Zheng, C. Zheng, W. Zhou, D. Zhou, S. Petrov, and Y. Wu (2023) PaLM 2 technical report. External Links: Cited by: §II-B.
- [3] B. P. Bailey and J. A. Konstan (2006) On the need for attention-aware systems: measuring effects of interruption on task performance, error rate, and affective state. Computers in human behavior 22 (4), pp. 685–708. Cited by: §I, §I, §II-C.
- [4] B. Gucsi, N. T. V. Tuyen, B. Chu, D. Tarapore, and L. Tran-Thanh (2025) User-aware collaborative learning in human-robot interactions. In Proceedings of the 2025 IEEE International Conference on Robotics and Automation (ICRA), pp. 7399–7406. Cited by: §I, §II-C.
- [5] J. Holland, L. Kingston, C. McCarthy, E. Armstrong, P. O’Dwyer, F. Merz, and M. McConnell (2021) Service robots in the healthcare sector. Robotics 10 (1), pp. 47. Cited by: §I.
- [6] A. Hurst, A. Lerer, A. P. Goucher, A. Perelman, A. Ramesh, A. Clark, A. Ostrow, A. Welihinda, A. Hayes, A. Radford, et al. (2024) Gpt-4o system card. arXiv preprint arXiv:2410.21276. Cited by: §III-A.
- [7] B. Ichter, A. Brohan, Y. Chebotar, C. Finn, K. Hausman, A. Herzog, D. Ho, J. Ibarz, A. Irpan, E. Jang, R. Julian, D. Kalashnikov, S. Levine, Y. Lu, C. Parada, K. Rao, P. Sermanet, A. T. Toshev, V. Vanhoucke, F. Xia, T. Xiao, P. Xu, M. Yan, N. Brown, M. Ahn, O. Cortes, N. Sievers, C. Tan, S. Xu, D. Reyes, J. Rettinghouse, J. Quiambao, P. Pastor, L. Luu, K. Lee, Y. Kuang, S. Jesmonth, N. J. Joshi, K. Jeffrey, R. J. Ruano, J. Hsu, K. Gopalakrishnan, B. David, A. Zeng, and C. K. Fu (2023) Do As I Can, Not As I Say: grounding language in robotic affordances. In Proceedings of the 6th Conference on Robot Learning(CoRL), pp. 287–318. Cited by: §I, §II-A, §III-A.
- [8] A. Joshi, S. Kale, S. Chandel, and D. K. Pal (2015) Likert scale: explored and explained. British journal of applied science & technology 7 (4), pp. 396–403. Cited by: §IV.
- [9] S. Mannem, W. Macke, P. Stone, and R. Mirsky (2023) Exploring the cost of interruptions in human-robot teaming. In Proceedings of the 2023 IEEE-RAS 22nd International Conference on Humanoid Robots (Humanoids), Cited by: §I, §I, §II-C.
- [10] R. Memmesheimer, J. Nogga, B. Pätzold, E. Kruzhkov, S. Bultmann, M. Schreiber, J. Bode, B. Karacora, J. Park, A. Savinykh, et al. (2024) RoboCup@ home 2024 opl winner nimbro: anthropomorphic service robots using foundation models for perception and planning. arXiv preprint arXiv:2412.14989. Cited by: §I.
- [11] Y. Obinata, N. Kanazawa, K. Kawaharazuka, I. Yanokura, S. Kim, K. Okada, and M. Inaba (2023) Foundation model based open vocabulary task planning and executive system for general purpose service robots. arXiv preprint arXiv:2308.03357. Cited by: §I.
- [12] D. R. Olsen and M. A. Goodrich (2003) Metrics for evaluating human-robot interactions. In Proceedings of PERMIS, Cited by: §I, §I, §II-C.
- [13] T. Ono, D. Kanaoka, T. Shiba, S. Tokuno, Y. Yano, A. Mizutani, I. Matsumoto, H. Amano, and H. Tamukoh (2022) Solution of World Robot Challenge 2020 Partner Robot Challenge (Real Space). Advanced Robotics 36 (17), pp. 870–889. Cited by: §I.
- [14] OpenAI GPT-4. Note: https://openai.com/research/gpt-4Accessed 12. Feb. 2025 Cited by: §II-B.
- [15] A. Radford, J. W. Kim, T. Xu, G. Brockman, C. McLeavey, and I. Sutskever (2023) Robust speech recognition via large-scale weak supervision. In Proceedings of the 40th International Conference on Machine Learning (ICML), pp. 28492–28518. Cited by: §II-B.
- [16] A. Z. Ren, A. Dixit, A. Bodrova, S. Singh, S. Tu, N. Brown, P. Xu, L. Takayama, F. Xia, J. Varley, et al. (2023) Robots that ask for help: uncertainty alignment for large language model planners. In proceedings of the Conference on Robot Learning (CoRL), Cited by: §I, §I, §II-B, §II-C.
- [17] RoboCup@Home. Note: http://www.robocupathome.org Accessed 15. Feb. 2025 Cited by: §IV.
- [18] M. Shirasaka, T. Matsushima, S. Tsunashima, Y. Ikeda, A. Horo, S. Ikoma, C. Tsuji, H. Wada, T. Omija, D. Komukai, Y. Matsuo, and Y. Iwasawa (2024) Self-recovery prompting: promptable general purpose service robot system with foundation models and self-recovery. In Proceedings of 2024 IEEE International Conference on Robotics and Automation (ICRA), pp. 17395–17402. Cited by: §I, §II-B.
- [19] R. Wang, Z. Yang, Z. Zhao, X. Tong, Z. Hong, and K. Qian (2024) LLM-based robot task planning with exceptional handling for general purpose service robots. In Proceedings of the 2024 43rd Chinese Control Conference (CCC), pp. 4439–4444. External Links: Cited by: §I.
- [20] T. Yamamoto, K. Terada, A. Ochiai, F. Saito, Y. Asahara, and K. Murase (2019) Development of human support robot as the research platform of a domestic mobile manipulator. ROBOMECH journal 6 (4). Cited by: §IV.
- [21] K. Yamao, D. Kanaoka, K. Isomoto, and H. Tamukoh (2024) Task planning system for home service robots capable of commands containing abstract nouns. In Proceedings of JSME the 8th International Conference on Advanced Mechatronics (ICAM 2024), pp. 5–7. Cited by: §I.
- [22] K. Yamao, D. Kanaoka, K. Isomoto, and H. Tamukoh (2025) Object positions interpretation system for service robots through targeted object marking. In proceedings of the 2025 IEEE/SICE International Symposium on System Integration (SII), pp. 998–1003. External Links: Cited by: §I.
- [23] Y. Yano, K. Isomoto, T. Ono, and H. Tamukoh (2024) Autonomous Waiter Robot System for Recognizing Customers, Taking Orders, and Serving Food. In Proceedings of the RoboCup 2023: Robot World Cup XXVI, pp. 252–261. Cited by: §I.
- [24] Y. Yano, A. Mizutani, Y. Fukuda, D. Kanaoka, T. Ono, and H. Tamukoh (2024) Unified understanding of environment, task, and human for human-robot interaction in real-world environments. In proceedings of the 2024 33rd IEEE International Conference on Robot and Human Interactive Communication (ROMAN), pp. 224–230. Cited by: §II-A.
- [25] X. Zhou, R. Girdhar, A. Joulin, P. Krähenbühl, and I. Misra (2022) Detecting twenty-thousand classes using image-level supervision. In European Conference on Computer Vision (ECCV), pp. 350–368. Cited by: §II-B.