사람이 보기에 적절한 파지 상태를 로봇에 전달하는 학습 체계
Human-Centric Grasp State Assessment: Toward Transferring Subjective Evaluation to Robots
원문 v1의 초록·본문 전체·연구 지원을 한국어로 번역했습니다. 그림 9개, 표 4개, 수식 2개와 참고문헌 21개를 포함하며 원문에는 부록이 없습니다. 그림 내부 영문·수치는 원형을 보존하고 캡션·표 머리글은 한국어로 옮겼습니다. 로봇노드 AI의 비공식 번역입니다.
초록
변형 가능한 물체를 적절하게 집기 위해, 사람의 암묵적이고 주관적인 기준을 로봇 시스템으로 전달하는 체계를 제안한다. 정성적인 인간의 기대와 정량적인 로봇 측정 사이에는 의미적 간극이 있어 이를 달성하기 어렵다. 기존 딥러닝 접근은 새로운 물체마다 사람이 표시한 대량의 데이터도 요구한다. 이 문제를 해결하기 위해 시각언어모델(VLM) 기반의 반자동 지도 데이터 생성기와 경량 파지 상태 예측기를 결합한다. 소수의 사람이 주석을 단 시행을 맥락적 기준점으로 사용하여 나머지 데이터로 주관적 기준을 전파한다. 예측 모델은 시계열 촉각 및 파지력 측정에서 파지 상태를 순차 추정해 빠른 온라인 적응을 가능하게 한다. 대표적인 변형 가능 물체 3종의 실험과 25명의 인간 평가를 통해, 평가한 과제 환경에서 사람이 느끼는 파지 적절성에 맞춰 힘을 조절하는 접근의 실행 가능성을 보인다.
I. 서론
가정과 편의점 같은 비정형 환경에서 생활용품과 식품을 다룰 수 있는 이동형 매니퓰레이터의 수요가 최근 빠르게 증가했다[13,15,20]. 이 환경에는 형태·재질·강성이 다양한 물체가 있고, 로봇이 미리 알지 못하는 물체도 많다. 따라서 자율 로봇은 새롭게 마주치는 물체를 계속 다뤄야 한다.
강성이나 파손되기 쉬운 정도 등 물성이 사전에 알려져 있지 않으므로 적절한 파지 전략을 정하는 일이 중요한 과제다. 로봇은 불확실성 속에서도 미끄러짐과 구조적 파손을 피하면서 안정적으로 상호작용하도록 힘을 조절해야 한다. 힘이 부족하면 미끄러지고 과도하면 구조가 손상되므로, 변형 가능한 물체의 파지는 섬세한 균형을 요구한다[21].
이러한 기본적인 물리적 안전성뿐 아니라 사람의 암묵적이고 주관적인 기준에도 맞아야 한다. 단순한 수치 임계값은 물체의 외관과 촉감상 온전함을 유지하려는 미묘한 기대를 충분히 표현하지 못한다. 본 연구는 인간 중심 로봇 조작의 대표 과제로 변형 가능한 물체의 파지를 다룬다. 기준은 물체의 재질과 강성에 따라 달라진다. 단단한 물체를 안전하게 잡는 힘이 부드러운 물체를 찌그러뜨릴 수 있고, 약한 힘은 마찰이 부족해 미끄러지게 할 수 있다. 로봇은 촉각 분포와 토크 같은 객관적인 수치에 의존하므로 사람의 시각적 기대를 제어 매개변수로 직접 연결할 수단이 없다. 그림 1의 문제 상황처럼 정성적 인간 기준과 정량적 로봇 측정 사이에 큰 의미적 간극이 생긴다. 이러한 불일치는 인간–로봇 상호작용에서 신뢰를 낮출 수 있다[5].
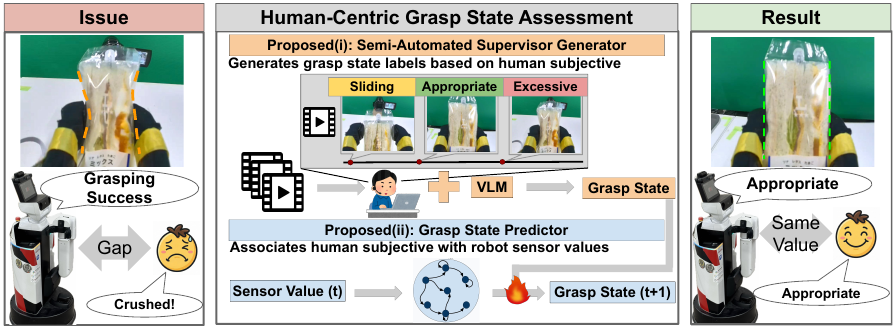
간극을 메우는 단순한 방법은 물체마다 물리적 임계값을 수동으로 정하는 것이다. 하지만 다양한 물체가 등장하는 개방 환경에서는 확장성이 없으며 주관적인 평가를 단순한 수치 경계로 환원할 수도 없다. Cui 등은 시각·촉각 정보로 파지 상태를 미끄러짐·적절·과도의 세 범주로 추상화했다[2]. 그러나 이 딥러닝 접근은 대규모 주석 데이터를 요구하여 새로운 물체에 적응하기에는 비실용적이다.
이러한 환경에서 계속 동작하는 인간 중심 접근에는 새로운 학습 기반이 필요하다. 과제 성공과 실패의 평가를 넘어 의미적 간극을 동적으로 메우고, 새 물체에 대한 인간의 인식을 빠르게 습득해 맞춰야 한다. 이에 주석 및 재학습 비용을 줄이면서 인간의 주관적 평가 기준을 로봇에 전달하는 체계를 제안한다. 목표는 평가한 환경에서 사람이 느끼는 적절성에 더 잘 맞는 파지 행동이다.
본 연구의 주요 기여는 다음과 같다.
-
•
소수의 인간 주관적 주석으로 초기화한 VLM을 이용하는 반자동 학습 데이터 생성 방식으로, 새로운 물체의 주석 비용을 줄이는 방법을 제안한다.
-
•
경량 시계열 학습 모델을 통합하여 물체별 적응을 순차적으로 수행하는 체계를 구현한다.
II. 관련 연구
이 절에서는 힘·촉각 피드백을 사용하는 변형 가능 물체의 파지, 시각·촉각 융합을 통한 파지 상태 평가, VLM을 이용한 학습 데이터 생성의 선행연구를 살펴본다.
A. 파지의 주관적 기준과 의미적 간극
그리퍼 힘 제어와 촉각 피드백은 변형 가능 물체의 조작 안정화에 널리 쓰였다[9,6,8]. 하지만 주로 미끄러짐 방지나 과도한 힘 감소 같은 물리적 안전성을 다뤄 주관적인 기준을 충분히 포착하지 못한다. 미끄러지지 않더라도 시각적 변형이나 외관 손실이 사람의 허용 범위를 넘으면 부적절한 파지로 느낄 수 있다. 판단은 재질·강성 같은 물체 특성에 의존하며 사람의 지도 없이 센서값만으로 바로 추론할 수 없다[10]. 제안 체계는 사람의 주관적 파지 상태와 해당 촉각·파지력 측정을 연관 짓는다. 미끄러짐 기반 제어가 물리적 안정성을 유지한다면 본 체계는 사람이 허용하는 변형 정도를 추정해 힘을 조절한다는 점에서 서로 보완적이다.
B. 파지 상태 평가의 효율성과 적응
Cui 등은 시각·촉각을 입력받아 미끄러짐·적절·과도의 세 상태로 분류하는 3차원 합성곱 기반 시각–촉각 융합 심층 신경망 C3D-VTFN을 제안했다[2]. 각각의 3D CNN이 시각 및 촉각 시계열을 처리한 뒤 완전연결층에서 시공간 특징을 합친다. 3축 촉각 분포를 이미지처럼 취급하므로 촉각 데이터에도 영상과 유사한 시계열 처리가 가능하다. 입력 프레임의 비율로 이미지 센서와 촉각 센서의 표본화 속도 차이를 흡수하여 비동기 이종 데이터에서 효과적인 융합 특징을 학습한다. 연구진은 16종 물체의 2만 표본으로 GSA 데이터셋을 구성해 99.98%의 분류 정확도를 보고했다.
그러나 심층 신경망 기반 방법은 대규모 사전 데이터 수집을 전제로 하며 모델 학습에도 상당한 시간이 필요하다. 새로운 물체가 끊임없이 등장하는 실제 환경에서 즉각적인 온라인 적응은 여전히 어렵다.
이를 해결하기 위해 학습 과정에서 인간의 주관적 평가를 촉각 및 그리퍼 힘과 연관 짓는다. 경량 모델이 이 기계적 데이터만으로 추론하도록 하여 데이터 요구량을 줄이고 새로운 물체에 빠르게 적응한다.
C. VLM을 이용한 지도 데이터 생성
딥러닝 접근의 데이터 수집 병목을 해결하기 위해 반자동 지도 데이터 생성에 주목한다. VLM은 이미지·영상 이해 성능이 높아 최근 지도 데이터 생성에 활용되고 있다[18,12]. 언어 지시를 바탕으로 맥락과 상황을 고려해 모호한 사건을 평가할 수 있고, 시각 입력을 근거로 판단의 설명과 추론도 생성할 수 있다.
하지만 VLM은 근거 없는 환각이나 모호한 상황에서 흔들리는 판단을 보이기도 한다[11]. 복잡한 물리 개념의 제로샷 추론도 인간의 기대에 맞지 않는 경우가 많다[3]. Silva-Rodríguez 등은 사전 학습한 텍스트 지식을 기준점으로 삼아 저비용 소수 예시 적응 과정에서 클래스 표현이 사전지식에서 크게 벗어나지 않도록 하는 반지도 접근을 제안했다[12]. Xu 등은 자동 처리 과정의 라벨 신뢰성을 위해 응답을 미리 정한 범주에 강제로 대응시키는 등 출력 형식을 구조화하는 중요성을 강조했다[18].
제안 체계는 구조화한 출력과 인간의 주관적 기준점을 결합해 지도 데이터를 생성한다. 최소한의 수동 개입으로 새 물체에 대해 안정적이며 인간 판단에 맞는 학습 데이터를 만들도록 한다.
III. 제안 체계
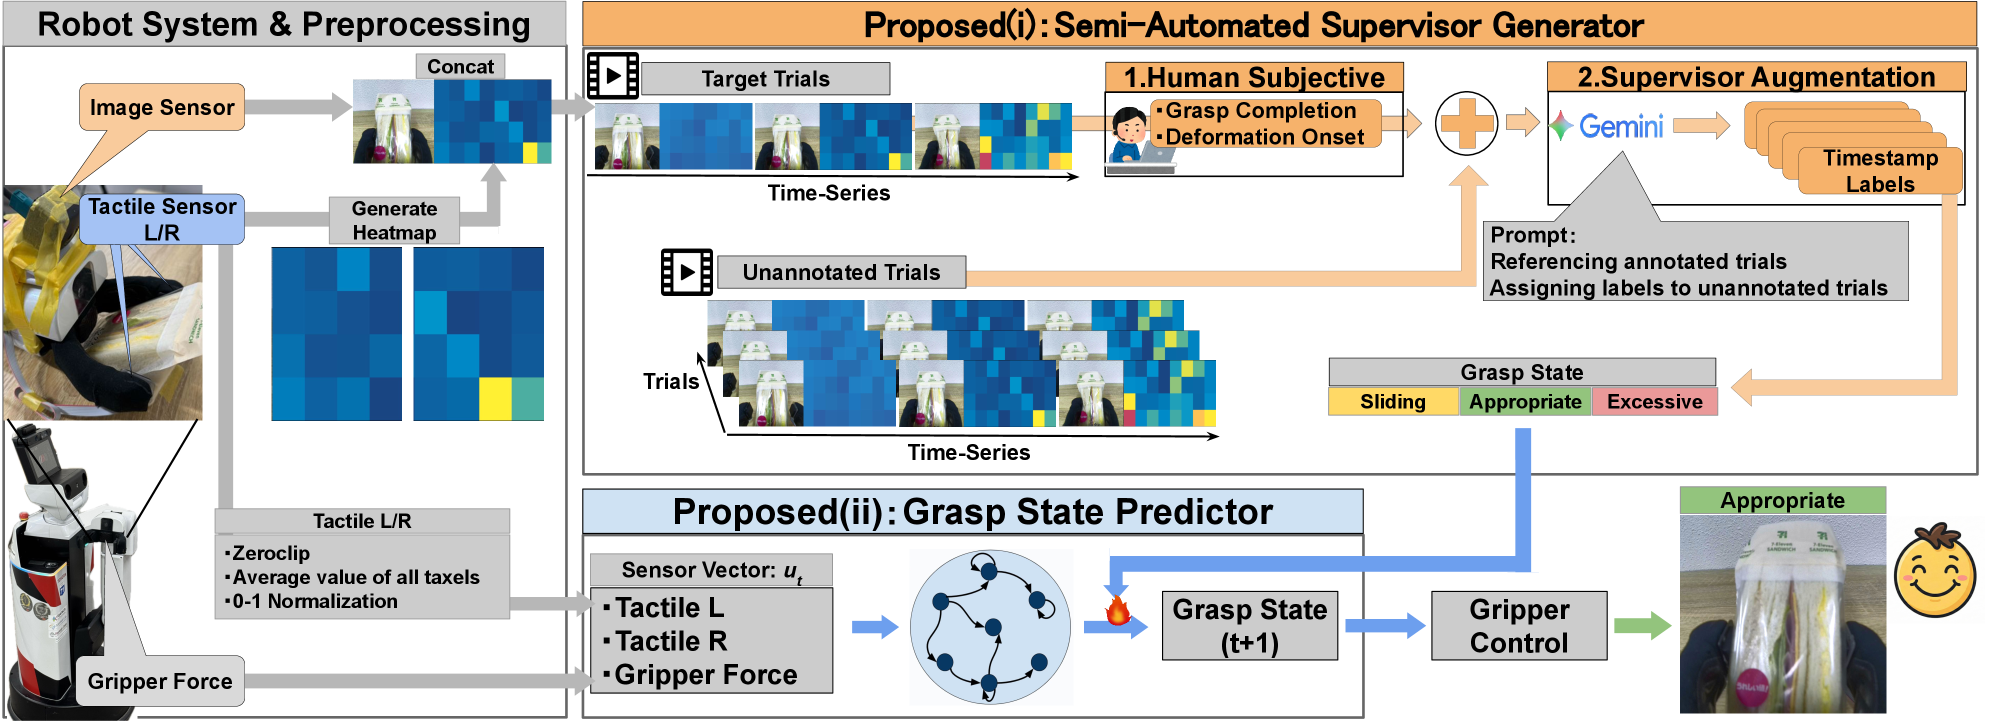
그림 2는 제안 체계다. 적은 주석으로 물체별 적응을 지원하기 위해 두 모듈을 결합한다.
-
•
지도 데이터 생성기(SG): 제한된 수의 인간 주관적 주석을 출발점으로 학습 데이터를 생성한다.
-
•
파지 상태 예측기(GSP): 촉각과 파지력의 시계열에서 한 단계 뒤의 미끄러짐·적절·과도 상태를 예측한다.
SG는 사람의 주석을 대체하는 대신 라벨링 비용을 줄인다. GSP에는 경량 모델을 사용하여 연속 동작 중 온라인 적응의 계산 비용을 실용적인 수준으로 유지한다.
A. 데이터셋 준비
로봇은 시각·촉각·파지력 정보로 파지 상태를 측정한다. 그림 2의 로봇 시스템 및 전처리 부분처럼 카메라, 촉각 센서와 그리퍼 힘의 데이터 및 주석 상태를 SG와 GSP에 적합한 구조로 만든다. 데이터셋은 손에 장착한 카메라의 RGB 이미지, 좌우 촉각 센서에서 누르는 방향을 나타내는 z축 변위, 실제 파지력으로 구성된다. RGB 이미지는 영상으로 묶는다.
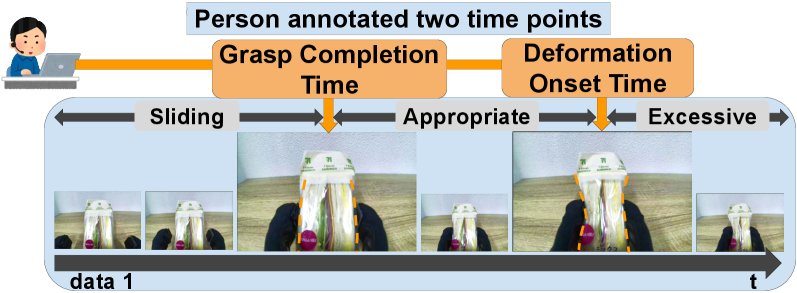
정답(GT) 라벨을 만들기 위해 사람이 RGB 영상을 보고 파지 완료 시점 t_grasp와 변형 시작 시점 t_deform을 수동으로 지정한다. 두 시점의 정의는 다음과 같다.
-
•
t_grasp: 그리퍼가 물체를 안정적으로 잡은 상태로, 그리퍼와 물체 사이에 틈이 없다고 시각적으로 판단할 수 있는 순간이다.
-
•
t_deform: 힘이 증가하면서 물체 윤곽이나 표면의 눌림 같은 시각적 변형이 나타나기 시작해 원래 외관이 손실됐다고 판단할 수 있는 순간이다.
그림 3처럼 이 시점들은 Cui 등[2]의 세 가지 이산 상태에 대응하며 다음과 같이 표현된다.
-
•
미끄러짐: t < t_grasp
-
•
적절: t_grasp ≤ t < t_deform
-
•
과도: t ≥ t_deform
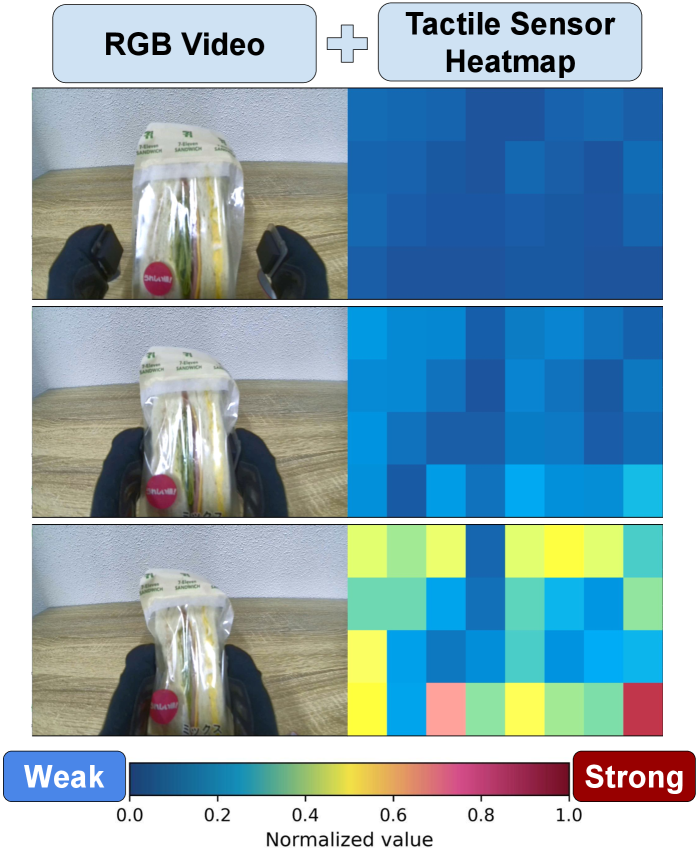
수집한 다중모달 데이터에서 두 가지 학습 형식을 만든다. 첫째는 SG가 시공간 상태 전이를 포착하도록 하는 영상이다. 그림 4처럼 손 카메라 RGB 이미지와 각 촉각 소자(taxel)의 z축 변위 열지도를 가로로 붙여 하나의 영상 스트림으로 만든다. 촉각 강도의 변화가 직관적으로 보이도록 cmthermal 색상표[1]를 사용한다.
둘째는 GSP가 기계적 상태 전이를 포착하는 시계열 표현이다. 좌우 촉각 센서 각각에 다음 데이터 정제 절차를 적용한다.
-
•
음수 값을 0으로 제한한다.
-
•
16개 촉각 소자 전체의 z축 변위 평균을 계산한다.
-
•
값을 [0,1] 범위로 정규화한다.
각 시간 단계에 정제한 좌우 촉각값과 파지력을 이어 붙여 3차원 특징 벡터를 만든다. 그림 2의 센서 벡터 u_t이며 식 (1)과 같다.
| (1) |
파지 중 힘은 0.1N에서 1.4N까지 0.1N씩 증가하므로 14개의 이산 시간 단계가 생긴다. 특징 벡터를 시간 순으로 쌓아 파지 중 기계적 상호작용의 변화를 나타내는 3×14 시계열 행렬을 얻는다.
B. 지도 데이터 생성기(SG)
새 물체에 필요한 수동 주석의 과도한 비용을 줄이기 위해 소수 예시로 주관적 판단을 기준화하는 SG를 제안한다. VLM은 물체가 정확히 언제 변형되기 시작하는지와 같은 연속적인 물리 변화 분석에서 환각과 불안정한 경계 판단을 보이기 쉽다. 과도 상태의 인식은 본질적으로 주관적이며 물체에 따라 다르므로 일반적인 언어 지시만으로는 로봇 제어에 필요한 고정밀 라벨링을 보장하기 어렵다.
이를 해결하기 위해 최소한의 인간 주석 시행을 맥락적 기준점으로 사용한다. VLM에는 텍스트 프롬프트와 라벨을 붙일 대상 영상, 사람이 지정한 시점 라벨을 가진 참조 영상 묶음을 소수 예시로 함께 제공한다. 이 영상–라벨 쌍을 명시적 기준으로 삼아 모델의 내부 판단을 인간 기준에 맞춘다. 같은 물체 범주의 남은 미주석 시행으로 주관적 기대를 전파할 수 있다.
SG와 GSP를 자연스럽게 연결하기 위해 출력은 미리 정의한 JSON 형식으로 제한한다. 시점과 추론 문자열을 자동으로 해석할 수 있어 안정적인 데이터 처리 과정을 구성한다.
결과적으로 SG는 최소한의 인간 개입을 물체별 학습 데이터셋으로 바꾸는 연결고리다. 소수 예시 기준점으로 VLM의 평가를 구체적인 인간 기준에 맞추어 수동 작업을 크게 줄이면서 인간 중심 제어를 학습하게 한다.
C. 파지 상태 예측기(GSP)
GSP는 그림 2 오른쪽 아래처럼 한 단계 뒤(t+1)의 파지 상태를 순차 추론하는 경량 모듈이다. 주관적 상태 라벨을 재질별 기계적 신호 특성과 연결함으로써 정성적인 인간 시각 기준을 정량적인 로봇 실행으로 전달한다.
시간 t마다 좌우 촉각값과 그리퍼 힘으로 구성된 센서 벡터 u_t를 받아 다음 상태 전이를 예상한다. 실시간 예측을 위해 입력층·고차원 리저버층·선형 출력층으로 구성된 에코 상태 네트워크(ESN)[7]를 사용한다. 리저버는 물리적 상호작용 신호의 복잡한 동역학과 이력을 포착하는 비선형 시간 필터다. 내부 가중치는 고정되므로 시간 패턴을 선형 분리 가능한 공간으로 옮기는 고차원 커널로 작용한다. 효율적인 닫힌형 해를 갖는 릿지 회귀로 최종 출력층만 최적화하여 계산 비용을 크게 줄인다. 모든 물체에 보편적인 단일 매개변수를 쓰는 대신, 새 물체 범주별로 출력 가중치 행렬을 개별 보관한다. 행렬을 바꾸는 것만으로 고유한 변형 특성에 즉시 적응한다.
IV. 실험
의미적 간극을 메우고 빠르게 적응하는 효과를 다음 구조로 평가한다.
-
•
A. 데이터셋과 설정: 서로 다른 3종 물체의 다중모달 데이터 수집 및 정답 정의를 제시해 실험 기준을 마련한다.
-
•
B. SG 신뢰성: 예시 수에 따른 라벨 정확도로 수동 데이터 수집 병목의 완화를 평가한다.
-
•
C. GSP 성능: 경량 예측 모델을 다음 네 기준으로 검증한다.
-
1.
적응성: 점진적 학습의 수렴 속도를 측정하여 새 물체에 대한 빠른 온라인 적응 능력을 확인한다.
-
2.
예측성: 한 단계 뒤 상태의 추정 정확도로 모델의 기본적인 예측 성능을 확인한다.
-
3.
실시간 안정성: 실제 로봇의 운반 과제에서 동적인 환경의 동작 신뢰성을 검증한다.
-
4.
인간 주관적 판단과의 일치: 25명의 평가와 로봇 행동을 비교하여 의미적 간극을 메우는지 확인한다.
-
1.
A. 실험 설정 및 데이터 수집
III-A절의 준비 절차에 따라 실험 데이터셋을 구성했다. 그림 2처럼 Toyota Human Support Robot[19]의 그리퍼로 데이터를 수집했다. 그리퍼 위의 TierIV C1 이미지 센서[14]는 RGB 영상을 기록하고, 양쪽 손가락 끝의 XELA uSkin 촉각 센서[16]는 누르는 방향인 z축 변위를 측정한다. 실제 파지력도 동기화해 기록했다.
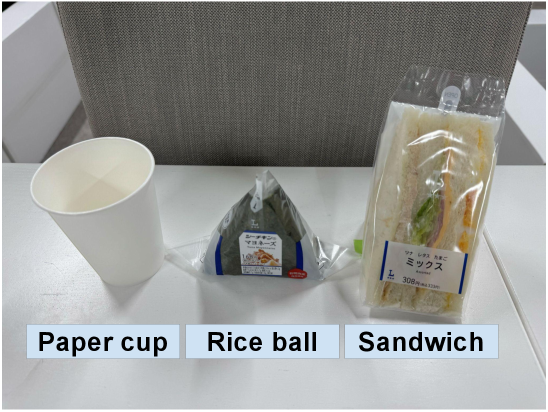
그림 5의 대상은 주먹밥·샌드위치·종이컵이다. World Robot Summit Future Convenience Store Challenge 공식 규칙[17]을 참고해 가정·편의점 같은 비정형 환경에서 흔히 접하는 대표적인 변형 가능 물체를 선택했다.
물체마다 독립적인 파지 시행 4회를 수행해 총 12개 데이터 시퀀스를 얻었다. 각 시행에서 힘을 0.1N에서 1.4N까지 점진적으로 올리며 다중모달 센서 데이터를 수집했다. 절대적인 정답 기준을 만들기 위해 사람이 방법론의 시각적 변형 기준에 따라 12개 시퀀스 전체에 세 상태 라벨을 부여했다. 완전히 주석된 이 데이터셋은 IV-B절의 SG 추론 정확도와 IV-C절의 GSP 적응성·예측성을 평가하는 기준이다.
B. 지도 데이터 생성기 평가
미주석 데이터의 시점 지정 정확도를 평가하기 위해 Google Gemini 3 Pro API[4]를 핵심 VLM으로 사용했다. 소수 예시의 전파에 의존하므로 인간이 제공하는 맥락의 양이 정확도에 주는 영향을 살폈다. 물체 범주별로 주석 예시 영상을 0개·1개·2개 제공하는 프롬프트를 비교했다. 예시 수가 늘면 남은 평가 대상 미주석 시퀀스는 원래 12개에서 9개, 6개로 줄어든다. 예시 선택 편향을 피하기 위해 시행을 4개 부분으로 나누고 번갈아 평가하며 나머지에서 설정에 맞는 예시를 제공하는 4겹 교차검증을 사용했다. 초기 지도의 양에 따라 인간 주관적 기준이 새 시행에 얼마나 효과적으로 전달되는지 비교한다.
| 물체 | 주석 예시 0개 | 주석 예시 1개 | 주석 예시 2개 | |||
|---|---|---|---|---|---|---|
| 정확도 | F1 점수 | 정확도 | F1 점수 | 정확도 | F1 점수 | |
| 주먹밥 | 0.74 | 0.64 | 0.94 | 0.92 | 1.00 | 1.00 |
| 샌드위치 | 0.84 | 0.71 | 1.00 | 1.00 | 1.00 | 1.00 |
| 종이컵 | 0.72 | 0.67 | 0.97 | 0.95 | 0.97 | 0.94 |
표 1은 세 프롬프트 설정의 정량적 분류 성능이다. 주석 예시가 없을 때 모든 물체에서 정확도와 F1이 가장 낮아, 인간의 안내 없이 VLM이 적절한 기준을 스스로 세우기 어렵다는 점을 보여준다. 예시 하나는 전반적인 점수를 크게 높였지만, 미끄러짐–적절 또는 적절–과도 경계의 인접 프레임을 종종 혼동했다. 예시 두 개는 경계의 모호성을 효과적으로 해소했다. 주먹밥과 샌드위치의 정확도·F1이 더 높아졌고, 종이컵은 정확도 0.97, F1 0.94의 높은 성능을 유지했다.
이 결과는 인간이 주석을 단 시행 두 개만으로도 충분한 맥락적 기준을 제공해 주관적 시각 기준을 미주석 데이터로 신뢰성 있게 전파할 수 있음을 나타낸다. 개선된 분류 성능은 뒤따르는 예측 모듈용 학습 데이터 생성의 신뢰성을 뒷받침한다.
C. 파지 상태 예측기 평가
GSP는 적응성(IV-C1), 예측성(IV-C2), 안정성(IV-C3), 인간의 주관적 평가와 일치(IV-C4)의 네 측면에서 평가했다. SG가 만드는 시점 추정 오류와 분리해 GSP 자체의 예측 능력을 평가한다. 따라서 보고된 점수는 사람이 주석을 단 라벨 아래에서의 예측 모듈 성능 상한이며, SG에서 GSP까지 이어진 전체 처리 과정의 성능은 아니다.
Optuna로 하이퍼파라미터를 최적화하고 시험 데이터 파형 추적의 평균제곱근오차(RMSE)를 최소화하는 조합을 선택했다. 조정 편향을 없애고 공정하게 비교하려고 네 GSP 실험 전체에서 같은 설정을 고정했다. 표 2는 ESN과 릿지 회귀의 매개변수다.
| 매개변수 | 값 |
|---|---|
| ESN 노드 수 | 628 |
| 입력 배율 | 0.671 |
| 순환 배율 | 0.366 |
| 연결 희소도 | 0.816 |
| 누출률 | 0.808 |
| 릿지 회귀 정규화 계수 | 0.0045 |
1. 적응성 평가
새 물체에 대한 온라인 적응성을 평가하기 위해 연속 동작 중 예측 모델이 안정되는 속도를 조사했다. III-C절처럼 물체별 출력 가중치를 점진적으로 갱신한다. 각 물체의 학습 데이터를 시퀀스 1개에서 3개까지 순차적으로 늘리고, 각 단계에서 해당 물체의 남은 미관측 시행으로 갱신한 가중치를 평가했다. 최소한의 물리적 상호작용으로 인간 중심 기준에 얼마나 빠르게 수렴하는지 보여주는 과정이다.
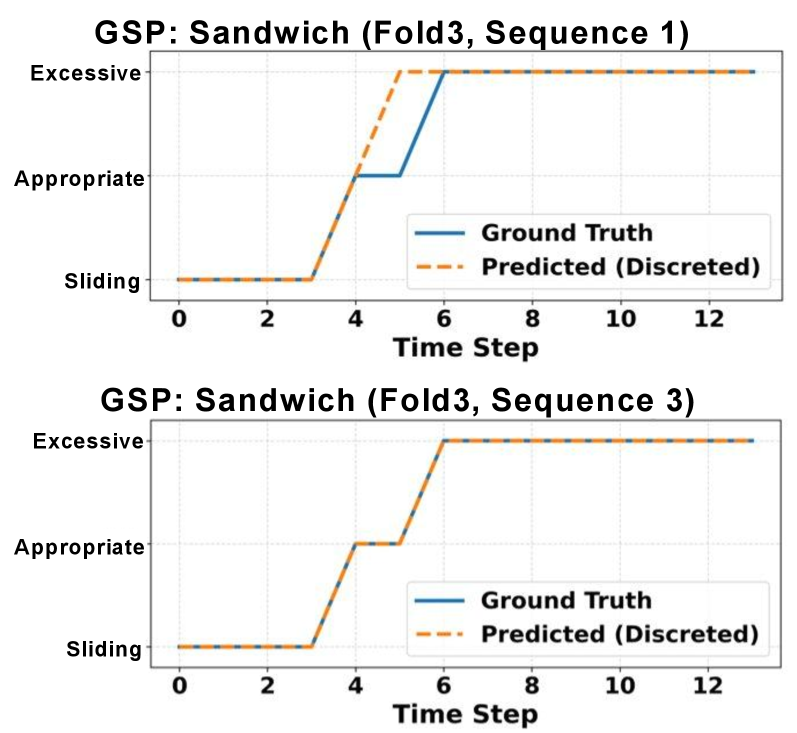
그림 6은 샌드위치에서 시퀀스 1개와 3개로 학습한 결과의 비교다. 세로축은 세 파지 상태이며 GT는 정답 라벨이다. 시퀀스 하나만 사용하는 초기에는 상태 전이 경계가 불안정했지만, 세 개로 늘리자 예측이 정답과 일치했다.
결과는 학습 데이터가 적더라도 새로운 물체의 평가 기준에 GSP가 빠르게 적응할 수 있음을 시사한다.
2. 예측성 평가
충분히 적응한 GSP가 센서 정보 u_t로 한 단계 뒤의 상태를 정확히 분류하는지 정량 평가했다. 물체마다 3개 시퀀스는 학습, 나머지 1개는 시험에 배정하는 4겹 교차검증을 수행했다. 정확도·F1 외에 정답의 적절 상태 구간을 예측이 얼마나 정확히 덮는지 나타내는 IoU@Appropriate를 사용했다.
식 (2)는 IoU@Appropriate의 정의다. T_GT는 정답에서 적절 상태인 시간 단계의 집합, T_pred는 모델이 적절 상태로 예측한 시간 단계의 집합이다. 분자는 두 집합의 교집합 크기, 즉 정답과 예측이 함께 적절하다고 판단한 구간이고, 분모는 합집합 크기, 즉 둘 중 하나라도 적절하다고 판단한 구간이다.
| (2) |
| 물체 | 정확도 | F1 점수 | IoU@Appropriate |
|---|---|---|---|
| 주먹밥 | 1.00 | 1.00 | 1.00 |
| 샌드위치 | 1.00 | 1.00 | 1.00 |
| 종이컵 | 1.00 | 1.00 | 1.00 |
표 3에서 모든 물체의 모든 평가 지표가 1.0이었다. 본 연구의 통제된 물체별 적응 환경에서는 촉각·파지력 신호로 인간 주석의 상태 경계를 재현할 수 있음을 나타낸다. 다만 교차검증마다 시퀀스가 적으므로 폭넓은 일반화를 증명하는 결과가 아니라 현재 과제에서의 실행 가능성으로 해석해야 한다.
3. 안정성 평가
다음으로 GSP를 실제 로봇의 실시간 제어에 통합해 안정성을 평가했다. 목적은 실제 로봇에서 힘을 적절 상태 안에 유지할 수 있는지 확인하는 것이다.
열린 그리퍼가 탁자 위의 물체에 접근한 뒤 파지력을 0.1N씩 높였다. GSP가 다음 힘 단계에서 과도 상태가 될 것으로 예측하면 그 직전의 적절 상태 힘을 선택해 운반에 사용했다. 로봇은 물체를 들어 90도 회전하고 약 2m 이동한 뒤 내려놓았다. 세 물체마다 3회씩, 총 9회 시행했다. IV-C2절과 같이 정확도·F1·IoU@Appropriate로 추론 성능을 평가했다.
| 물체 | 정확도 | F1 점수 | IoU@Appropriate |
|---|---|---|---|
| 주먹밥 | 0.93 | 0.90 | 0.78 |
| 샌드위치 | 1.00 | 1.00 | 1.00 |
| 종이컵 | 1.00 | 1.00 | 1.00 |
| 전체 물체 | 0.98 | 0.97 | 0.93 |
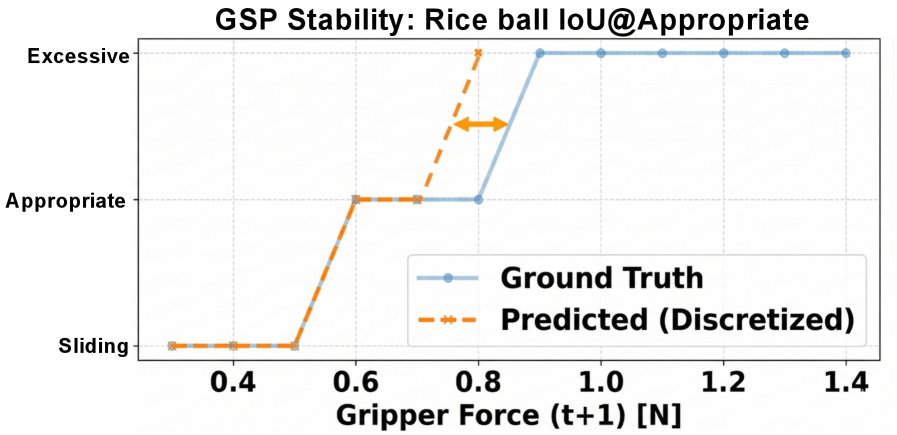
표 4는 실제 로봇 결과다. 전체 정확도는 0.98이지만 주먹밥에서는 0.93이었다. 주먹밥의 IoU@Appropriate를 보면 정답과 예측의 적절 구간에 차이가 있었다.
그림 7처럼 주먹밥에서는 예측이 정답보다 한 단계 먼저 과도 상태로 전환됐다. 비대칭적인 형태와 균일하지 않은 내부 밀도 때문에 잡는 위치의 작은 차이도 기계적 저항을 크게 바꿀 수 있다. 데이터 수집과 실제 실행 사이의 온도 변화 등 환경에 따라 강성도 달라진다. 제한된 균일 데이터에서 기준을 학습한 모델은 학습하지 않은 물리적 저항 증가를 변형 임계값 도달로 보수적으로 해석했다.
반면 예측에 따른 실제 정지 시점은 정답의 적절 구간 안에 있었고, 물체를 떨어뜨리거나 찌그러뜨리지 않고 과제를 달성했다. 실제 로봇 평가는 GSP 예측을 이용해 힘을 실시간으로 적절 상태에 유지하고 안정적으로 운반할 수 있음을 보여준다.
4. 인간의 주관적 평가
로봇 행동과 사람이 기대하는 적절성의 간극을 메웠는지 확인하기 위해 25명에게 주관적 평가를 실시했다. 참가자는 IV-C3절 실제 로봇 실험의 9개 영상을 봤다. 주먹밥 O1–O3, 샌드위치 S1–S3, 종이컵 P1–P3 각 3개다. 각 영상에서 관찰한 파지 상태를 직관적으로 미끄러짐·적절·과도 중 하나로 분류했다. 그림 8처럼 Google Forms 웹 설문을 사용했다.
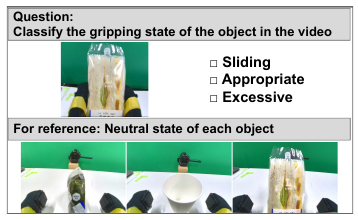
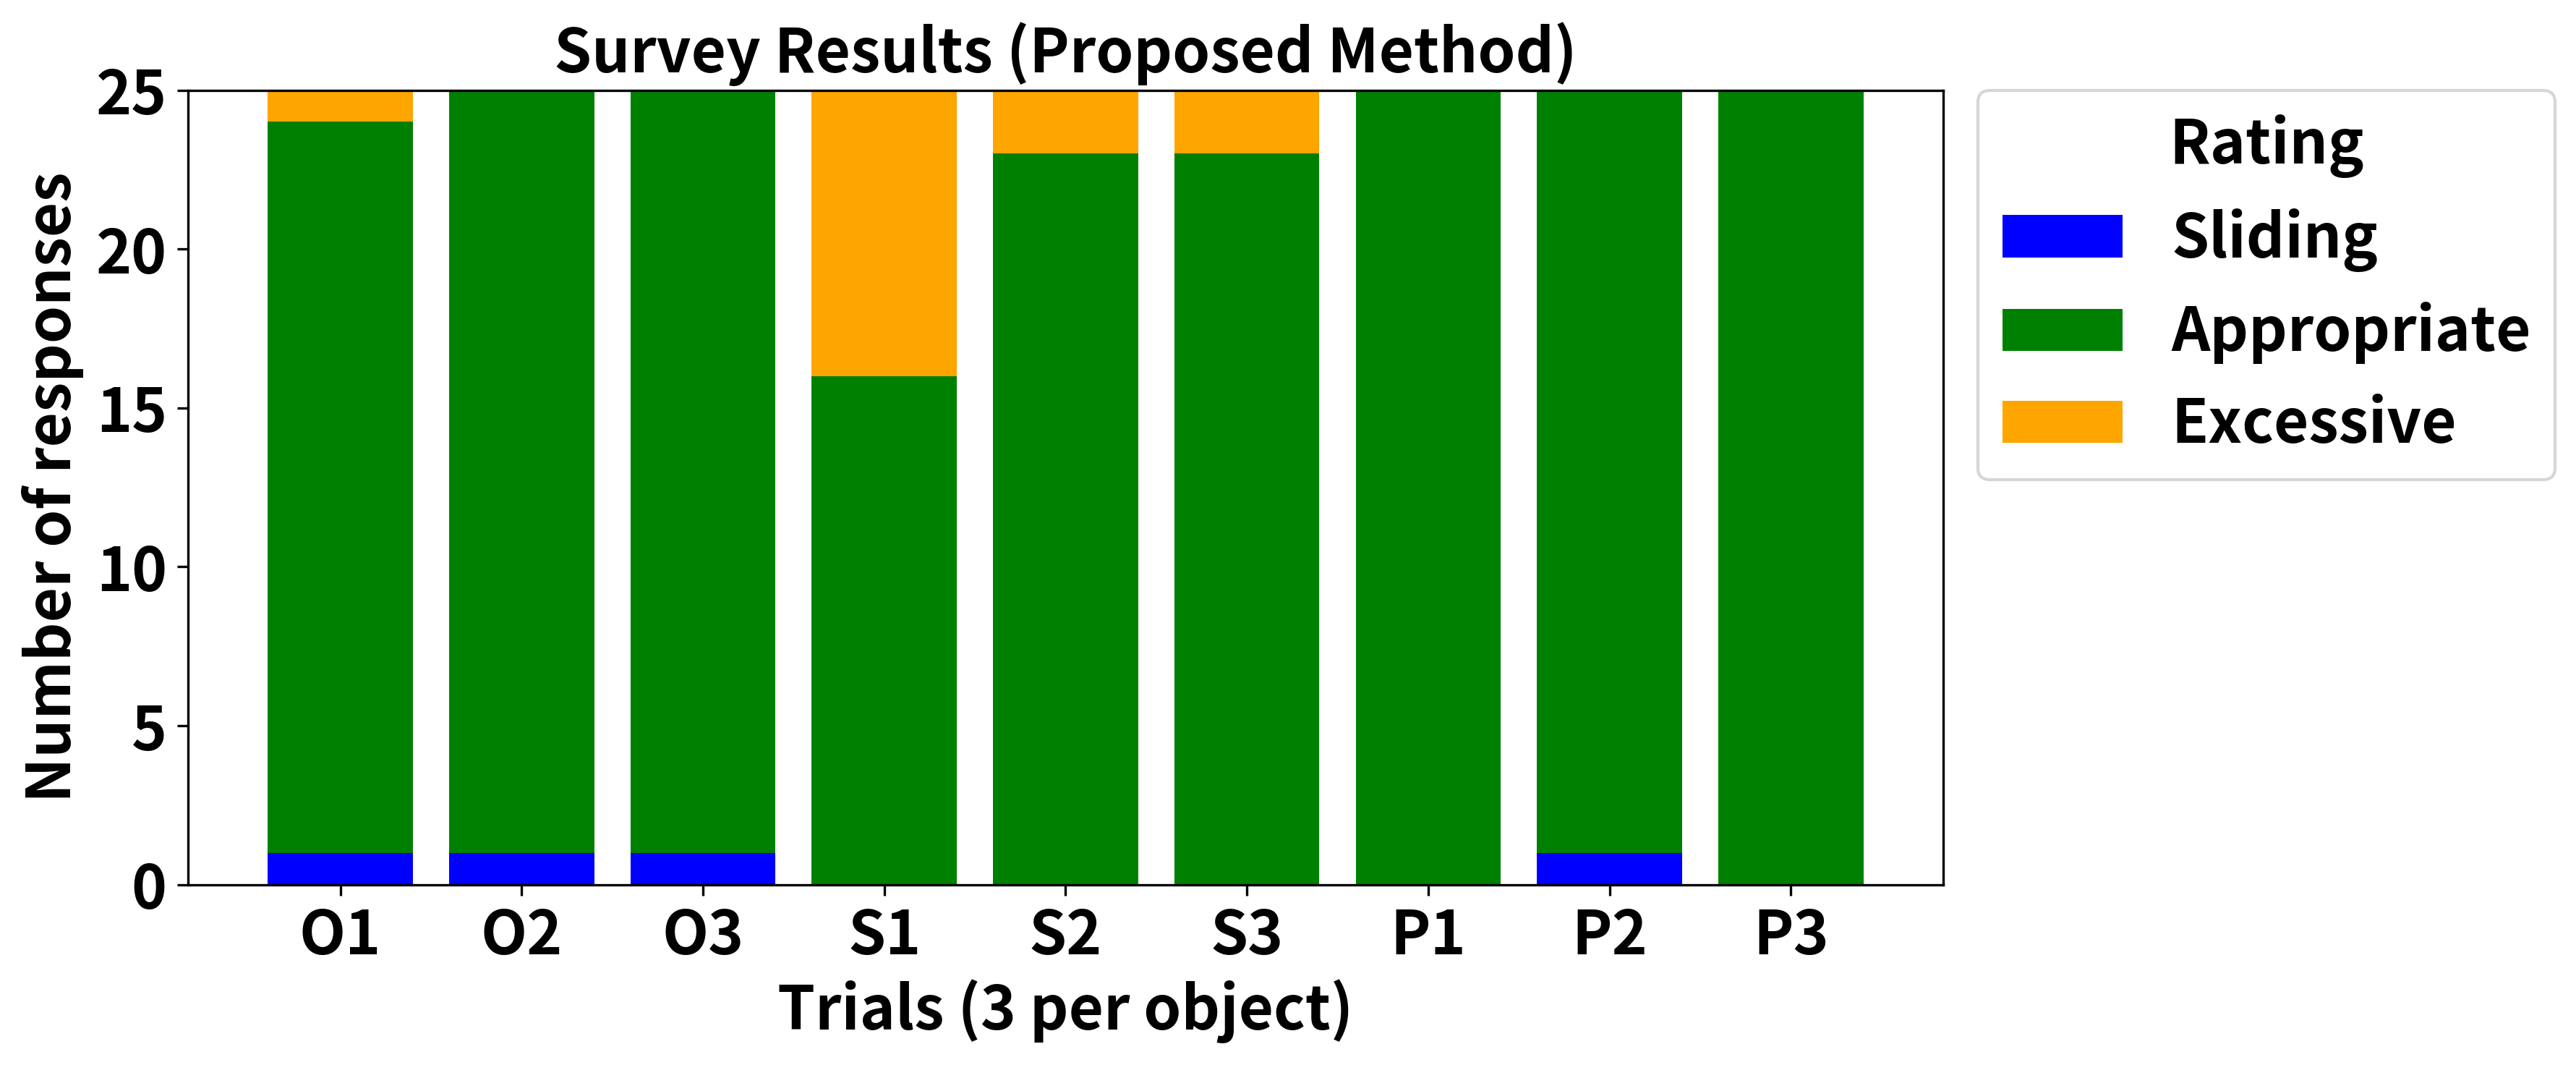
그림 9의 세로축은 응답자 수, 가로축은 실제 로봇 시행 9개다. 파랑은 미끄러짐, 초록은 적절, 주황은 과도를 뜻한다. 적절하다고 평가한 응답이 많다는 점은 GSP의 힘 조절 효과를 보여준다. S1을 제외한 모든 시행에서 적절하다는 평가가 90%를 넘었다.
평가가 갈린 S1은 중심에서 벗어난 파지 위치 때문에 물체가 시각적으로 약간 비틀려 보였기 때문으로 해석한다. 이러한 외관 변화 때문에 일부 참가자가 과도하다고 판단했을 가능성이 있다.
V. 한계 및 향후 연구
몇 가지 한계가 있다. 첫째, 세 물체와 적은 시퀀스만 평가했으므로 폭넓은 일반화가 아니라 실행 가능성의 근거로 해석해야 한다. 다른 종류의 샌드위치처럼 변형·촉각 반응이 크게 다른 물체 범주나 같은 범주 안의 변형에는 추가 인간 주석이 필요할 수 있다. 확장성을 높이기 위해 예측 오류와 상호작용적 인간 또는 언어 피드백을 학습 신호로 사용하고 더 다양한 물체·사용자·조작 상황으로 평가를 넓힐 예정이다. 둘째, 세 상태 표현은 인간 중심 적절성의 초기 근사이므로 확률적 또는 개인별 선호 모델을 검토해야 한다. 셋째, GSP를 인간 주석 라벨로 평가했으므로 SG에서 GSP까지 전체 과정의 오류 전파는 아직 평가해야 한다. 마지막으로 촉각 반응 변화를 다루기 위해 파지 자세 정보, 불확실성을 고려한 예측, 동적 미끄러짐 감지와 자세 보상을 포함할 계획이다.
VI. 결론
본 연구는 변형 가능한 물체에 대해 시각적으로 인식한 파지 적절성을 촉각·파지력 기반 예측으로 옮기는 인간 중심 파지 상태 평가 체계를 제시했다. 평가한 과제 환경에서 VLM의 도움을 받는 지도 데이터 생성과 경량 ESN 기반 물체별 적응의 실행 가능성을 보여준다. 향후에는 SG–GSP 전체 평가, 더 넓은 물체·과제 변화, 인간 또는 언어의 상호작용 피드백을 이용한 장기 적응을 다룰 것이다.
연구 지원
본 논문은 신에너지·산업기술종합개발기구(NEDO)가 위탁한 JPNP16007 과제의 성과를 바탕으로 한다. JSPS KAKENHI 23H03468 및 24KJ182, JST ALCA-Next JPMJAN23F3, JST SPRING JPMJSP2154의 지원을 받았다.
참고문헌
- [1] (2020) The misuse of colour in science communication. Nature communications 11. 외부 링크: 원문
- [2] (2020) Grasp State Assessment of Deformable Objects Using Visual-Tactile Fusion Perception. In Proc. 2020 IEEE International Conference on Robotics and Automation (ICRA), pp. 538–544.
- [3] (2024) Physically grounded vision-language models for robotic manipulation. In Proc. 2024 IEEE International Conference on Robotics and Automation (ICRA), pp. 12462–12469.
- [4] (2025) Gemini 2.5: Pushing the Frontier with Advanced Reasoning, Multimodality, Long Context, and Next Generation Agentic Capabilities. Note: arXiv preprint arXiv:2507.06261
- [5] (2011) A Meta-Analysis of Factors Affecting Trust in Human-Robot Interaction. Human Factors 53. 외부 링크: 원문
- [6] (2020) Tactile dexterity: Manipulation primitives with tactile feedback. In Proc. 2020 IEEE International Conference on Robotics and Automation (ICRA), pp. 8863–8869.
- [7] (2001) The “echo state” approach to analyzing and training recurrent neural networks. Technical report Technical Report GMD 148, German National Research Center for Information Technology.
- [8] (2016) Tactile-based manipulation of deformable objects with dynamic center of mass. In Proc. 2016 IEEE-RAS 16th International Conference on Humanoid Robots (Humanoids), pp. 752–757.
- [9] (2020) Theoretical derivation and realization of adaptive grasping based on rotational incipient slip detection. In Proc. 2020 IEEE International Conference on Robotics and Automation (ICRA), pp. 531–537.
- [10] (2024) Online elasticity estimation and material sorting using standard robot grippers. The International Journal of Advanced Manufacturing Technology 132. 외부 링크: 원문
- [11] (2018) Object Hallucination in Image Captioning. In Proc. 2018 Conference on Empirical Methods in Natural Language Processing (EMNLP),
- [12] (2026) Semi-Supervised Few-Shot Adaptation of Vision-Language Models. Note: arXiv preprint arXiv:2603.02959
- [13] (2020) An amygdala-inspired classical conditioning model implemented on an fpga for home service robots. IEEE Access 8. 외부 링크: 원문
- [14] (2023) Edge.Auto Documentation: C1 Camera Reference Manual. Note: Accessed: Jan. 22, 2026[Online]. Available: https://tier4.github.io/edge-auto-docs/ja/reference_manual/C1_technical_reference_manual.html
- [15] (2024) Object recognition and grasping point detection using carbon nanotube-polydimethylsiloxane nanocomposite sensor. Nonlinear Theory and Its Applications, IEICE 15. 외부 링크: 원문
- [16] (2016) A modular, distributed, soft, 3-axis sensor system for robot hands. In Proc. 2016 IEEE-RAS 16th International Conference on Humanoid Robots (Humanoids), pp. 454–460.
- [17] (2025) WRS Future Convenience Store Challenge 2025 Rulebook (Stock Disposal Task) [in Japanese]. (Japanese). Note: [Online]. Available: https://worldrobotsummit.org/wrs2025/fcsc/FCSC2025_stock_disposal_task_v006_JPN.pdfAccessed: Jan. 28, 2026
- [18] (2025) VLM-AD: End-to-End Autonomous Driving through Vision-Language Model Supervision. In Proc. 2025 Conference on Robot Learning (CoRL), pp. 3778–3803.
- [19] (2019) Development of Human Support Robot as the research platform of a domestic mobile manipulator. ROBOMECH Journal 6. 외부 링크: 원문
- [20] (2024) Autonomous waiter robot system for recognizing customers, taking orders, and serving food. In RoboCup 2023: Robot World Cup XXVI, pp. 252–261.
- [21] (2025) Deformable and Fragile Object Manipulation: A Review and Prospects. Sensors 25. 외부 링크: 원문