시연 15회로 로봇 삽입을 학습할 때 동작 정규화는 얼마나 도움이 되는가
Dissecting Motion-Prior Regularization for Data-Scarce Robotic Insertion
arXiv:2609.17484v1의 본문 전체 한국어 번역입니다. 그림 2개와 표 1개를 모두 포함합니다. 수식 기호와 참고문헌 서지정보는 원문을 보존했습니다. 원저자의 검토·승인을 받은 번역은 아닙니다.
Ning Hu¹*, Shuai Li², Jindong Tan¹
¹ 미국 테네시대학교 녹스빌, 기계·항공우주·의공학과
² 미국 플로리다대학교, 지속가능한 기반시설 및 환경 공학부
* 교신저자: Ning Hu (ning.hu.666@gmail.com)
초록
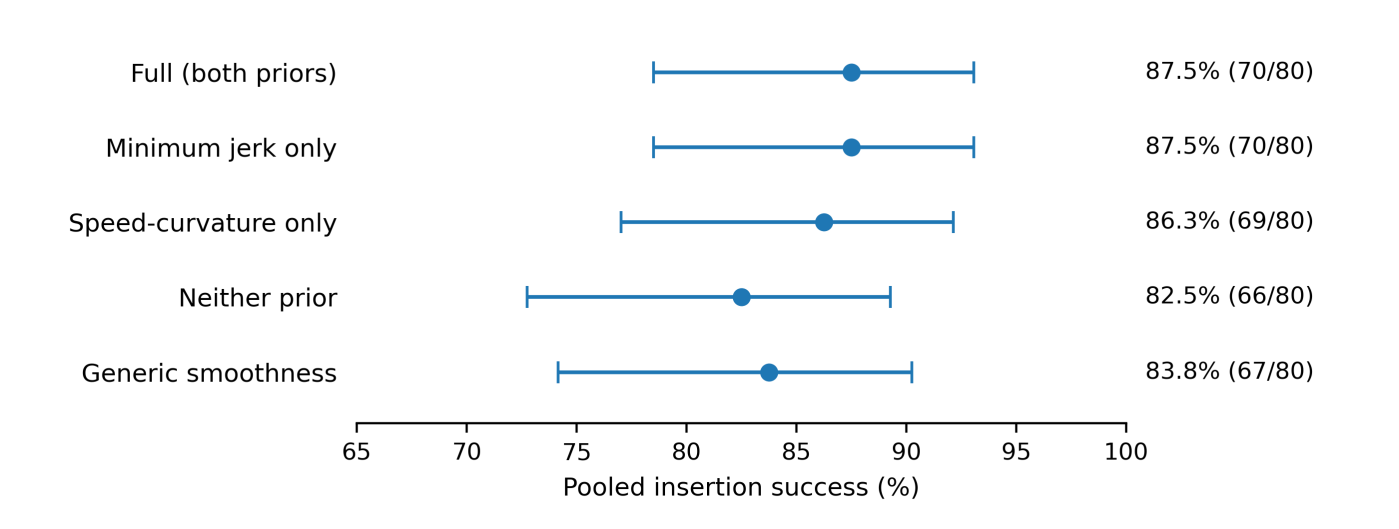
본 연구는 단 15회의 시연으로 확산 정책을 학습할 때, 학습 시 동작 사전지식 정규화가 삽입 성공률을 높일 수 있는지 묻는다. 최소 저크는 예측한 병진 가속도가 급격히 바뀌는 것을 억제한다. 반면 속도–곡률 정규화는 이동 속도와 경로의 기하학적 형상을 결합한다. 이들은 과제 완료를 위한 후보 메커니즘이며 안전성을 보장하는 조건은 아니다. 두 사전지식을 각각 사용한 경우와 함께 사용한 경우, 어느 것도 사용하지 않은 경우, 일반적인 평활화를 적용한 경우를 비교한다. 기록된 네 가지 조건 유형을 합쳐 설정마다 실제 로봇 실험 80회를 수행했다. 공동 적용과 최소 저크 단독 적용은 각각 80회 중 70회 성공(87.5%)했다. 속도–곡률 단독은 69/80(86.3%), 둘 다 미적용은 66/80(82.5%), 일반 평활화는 67/80(83.8%)였다. 성공률과 Wilson 95% 신뢰구간을 시각화해 직접 비교했다. 공동 정규화는 둘 다 미적용한 경우보다 5.0%포인트 높았지만, 최소 저크만 적용한 경우에 비해 관측된 이득은 없었다. 이 결과는 최소 저크를 재현 실험의 더 간단한 후보로 삼을 근거를 제공한다. 그러나 상승효과, 생체역학적 특이성, 안전성 향상 또는 분포 변화에 대한 강건성을 입증하지는 않는다.
I. 서론
정밀 삽입에는 지각의 불확실성, 엄격한 기하학적 공차, 접촉 동역학이 함께 작용한다. Diffusion Policy는 행동 시퀀스에 대한 조건부 잡음 제거로 다중 모드 로봇 행동을 모델링한다[1]. 힘을 고려하는 정책과 느린–빠른 정책은 접촉 중의 반응성을 개선한다[2,3]. 물체 중심 자세 표현[4]과 기하학적 등변성[5]도 데이터 효율적인 삽입에 기여했다. 이러한 진전 이후에도 더 좁은 학습 문제가 남는다. 시연이 15회뿐일 때 명시적인 동작 사전지식 페널티가 성공적인 삽입을 개선하는가?
주요 목표는 플러그를 뽑고, 옮기고, 삽입하는 전체 시퀀스의 완료로 측정하는 과제 성공이다. 동작의 규칙성은 이 목표를 달성하기 위한 가설적 수단이며, 본 연구에서 측정한 결과변수는 아니다. 강건성을 논하려면 조건별 평가가 필요하고, 안전성을 논하려면 직접적인 안전성 결과나 검증된 제약조건이 필요하다. 통합 성공률이나 평활화 페널티를 사용했다는 사실만으로 어느 쪽도 추론하지 않는다.
부드러운 행동 생성 자체는 새로운 것이 아니다. LiPo는 추론 시 학습된 행동 청크에 저크를 최소화하는 사후 최적화를 적용한다[6]. Frequency Guidance Operator(FGO)는 하위 주파수 다양체를 통해 잡음 제거를 유도한다[7]. 본 연구는 정책 학습 중에 최소 저크와 속도–곡률 페널티를 적용하고, 구성요소별 대조와 일반 평활화 대조를 통해 그 기여를 조사한다. 확립된 인간 운동의 규칙성[8–10]은 후보 귀납 편향을 제안하는 동기가 된다. 그러나 생물학적 기원을 가졌다는 사실만으로 삽입에 적합하다고 입증되지는 않는다.
우리는 두 사전지식이 각각, 그리고 함께 적용될 때 통합 삽입 성공률에 어떤 영향을 미치는지 묻는다. 기여는 다음과 같다. (i) 두 사전지식에 서로 다른 근거를 부여한 학습 목적함수, (ii) 정수 단위 실험 횟수와 신뢰구간 그래프를 포함한 다섯 설정의 진단, (iii) 관측된 성공 차이를 검증되지 않은 메커니즘·상승효과·강건성·안전성과 구분하는 구성요소별 해석이다.
II. 정책과 정규화
A. 정책 인터페이스
시각 t에서 정책은 다음을 관측한다.
여기서 It는 손에 장착한 카메라의 RGB 영상, TBE,t는 말단장치 자세, wt는 손목의 힘·토크 측정값이며, ℋ는 짧은 관측 이력이다. 정책은 짧은 시간 범위의 행동을 예측한다.
행동은 데카르트 좌표계의 병진·회전 증분, 그리퍼 명령 g, 순응성 코드 c로 이루어진다. ResNet-18 시각 인코더가 확산 헤드에 조건 정보를 제공한다. 학습은 10만~20만 반복으로 수행한다. 정책 추론은 10~20Hz로 실행하며, 보간한 데카르트 목표는 표준 임피던스 및 혼합 힘·위치 제어 원리[11,12]에 따른 순응성 저수준 제어로 50~200Hz에서 실행한다. 실험 기록에 남아 있지 않은 매개변수는 보고하지 않는다.
B. 최소 저크 사전지식: 근거와 목적함수
p0를 현재 데카르트 위치, p1, …, pH를 한 행동 청크의 예측 위치라 하자. 3차 유한차분은 다음과 같다.
최소 저크 페널티는 다음과 같다.
일정한 간격의 표본에서 3차 유한차분을 표본 간격의 세제곱으로 나누면 위치의 시간에 대한 3차 미분인 저크를 근사한다. 따라서 이 페널티는 청크 안에서 예측한 병진 가속도의 급격한 변화를 억제한다. 최소 저크 운동 모델[8,10]을 근거로, 시연이 적을 때 이 편향이 불필요한 짧은 시간 규모의 행동 변화를 억제하고 접촉 직전의 접근과 정렬을 더 쉽게 실행하도록 할 수 있다고 가정한다. 이는 과제 완료와의 연결에 관한 제안이며, 접촉 교란이 줄었다는 실험적 검증은 아니다.
이 페널티는 회전, 청크 사이의 불연속, 접촉력을 직접 제약하지 않는다. 과도한 평활화는 삽입에 필요한 빠른 수정 동작도 약화할 수 있다. 따라서 가중치는 규칙성과 시연 모방의 충실도 사이에서 균형을 잡아야 한다. 저크를 최소화하는 것만으로 과제 성공이나 안전한 상호작용이 보장되지는 않는다.
C. 속도–곡률 사전지식: 근거와 목적함수
내부 표본의 속도–곡률 정규화는 3분의 2 멱법칙 형태를 따른다.
ṽk와 κ̃k는 정규화한 속도와 곡률이며, α̃는 적합한 스케일이다. 음의 3분의 1 지수는 접선 속도와 경로 곡률을 사용해 3분의 2 멱법칙을 표현한 것이다[9,10]. 최소 저크와 달리 이 항은 시간과 기하를 연결한다. 가속도의 변화를 직접 벌점으로 주기보다는 곡률이 큰 경로 구간에서 낮은 속도를 선호한다. 이러한 조율이 접근이나 방향 재조정을 도울 수 있다는 가설이다. 그러나 접촉으로 인해 멈추거나 거의 직선으로 삽입하는 경우에는 도움이 되지 않을 수 있다. 이러한 상황에서는 경로 곡률만으로 적절한 속도를 정할 수 없기 때문이다.
두 목적함수의 효과가 반드시 합산되지는 않는다. 일부 궤적에서는 편향이 겹치고, 다른 궤적에서는 과제에 필요한 수정과 경쟁할 수 있다. 역곡률 형태는 곡률이 0에 가까울 때의 수치 처리 규칙도 필요하다. 남아 있는 원고에는 그 규칙, 정규화의 세부사항, 스케일 적합 절차가 명시되어 있지 않다. 그러한 구현 세부사항을 집계 결과로부터 재구성하지 않는다.
D. 공동 학습과 조건을 맞춘 대조군
전체 학습 목적함수는 다음과 같다.
확산 손실과 보조 행동 복제 손실은 모방 목적을 유지하며, 스칼라 가중치들은 추가 페널티를 제어한다. 변환 일관성 항은 범위가 제한된 SE(3) 변환을 관측과 행동 증분에 일관되게 적용한다. 이는 학습상의 제약이며 구조적으로 등변성을 갖는 신경망은 아니다. 보조 지각, 증강, 순응성, 유한상태 실행 구성요소는 다섯 설정에서 고정한다. 보고되지 않은 정확한 손실 가중치와 구현 매개변수는 여전히 확인할 수 없다.
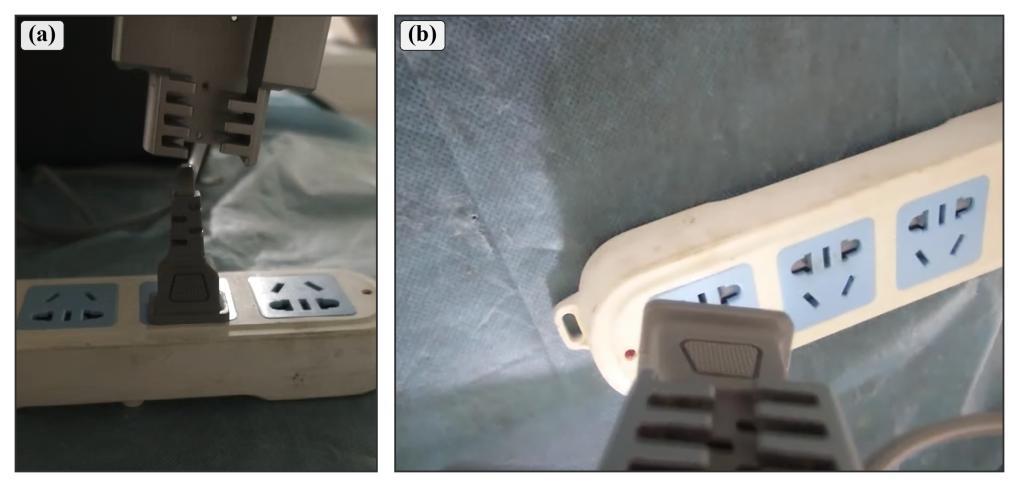
표 I은 조건을 맞춘 정규화 설정을 정의한다. 처음 네 설정은 구성요소 비교를 이룬다. 일반 평활화는 관측된 관련성이 선택한 동작 사전지식에 특유한 것인지 탐색한다. 이용 가능한 기록은 일반 페널티를 명시하지 않으며 정규화 강도가 일치함을 확립하지도 않는다. 따라서 특이성을 확인하는 제한적인 대조군이다. 그림 1은 물리적 과제를 보여주며, 정량 결과는 그림 2에서 별도로 제시한다.
III. 실험 절차와 결과
A. 플랫폼과 실험 횟수
실험에는 AUBO-i5 6자유도 매니퓰레이터, 손에 장착한 단안 RGB 카메라, 손목 장착형 6축 힘·토크 센서, 평행 그리퍼를 사용한다. 플러그를 뽑고 옮겨 삽입하는 시퀀스의 원격조작 시연 15회로 학습하며 시뮬레이터 사전학습은 사용하지 않는다. 평가는 Seen(학습에서 본 조건), Geometry(기하), Pose(자세), Lighting(조명)의 조건 유형에 걸쳐 이루어진다. 설정과 조건의 각 조합에 정확히 20회, 설정별로 합계 80회를 수행한다. 이들은 한 과제군 안의 조건 유형이며 서로 독립된 네 개의 과제가 아니다. 교란의 크기는 기록에 남아 있지 않아 보정된 스트레스 수준으로 취급하지 않는다.
성공은 주요 결과변수이자 유일한 분석 대상이다. 정해진 과제 수행 한도 안에 전체 시퀀스를 완료하고, 플러그가 완전히 삽입되어 안정 상태를 유지하며, 안전 중단이 없을 때 성공으로 판정한다. 정확한 수행 한도, 기하학적 공차, 유지 시간의 값은 확인할 수 없다. 중단은 과제 실패에 포함된다. 이러한 복합 정의로 안전성, 접촉력, 실패의 심각도를 각각 정량화할 수는 없다.
B. 결과 표시와 통계적 범위
그림 2는 정수 횟수, 그로부터 계산한 성공률, 양측 Wilson 95% 신뢰구간을 하나의 점·구간 그래프에 제시한다. 신뢰구간은 합친 결과에 대한 명목상 이항 요약이며, 학습 시드에 따른 변동이나 조건별 성능의 추정치가 아니다. 조건별 성공 횟수와 대응된 시행 기록을 사용할 수 없으므로 독립성, 대응 관계, 실행 간 변동을 확인할 수 없다. 따라서 분석은 기술적 분석이며, 대응 검정이나 분포 변화에 대한 강건성 추정은 수행하지 않는다. 구간의 겹침을 설정 간 차이나 동등성에 대한 검정으로 사용하지 않는다.
| 설정 | 적용 정규화 | 진단 역할 |
|---|---|---|
| 전체(Full) | 최소 저크 + 속도–곡률 | 공동 구성 |
| 저크만 | 최소 저크 | 저크 구성요소 |
| 속도–곡률만 | 속도–곡률 | 곡률 구성요소 |
| 둘 다 없음 | 어느 구성요소도 없음 | 요인 비교 기준 |
| 일반 평활화 | 생체역학에 기반하지 않은 평활화 | 특이성 대조 |
C. 구성요소별 성공 결과
전체 설정과 저크 단독 설정은 각각 70/80(87.5%)으로, 어느 사전지식도 사용하지 않은 66/80(82.5%)보다 네 번 더 성공했다(+5.0%포인트). 속도–곡률 단독은 69/80(86.3%)으로 미적용 기준보다 세 번 더 성공했다(+3.75%포인트). 일반 평활화는 67/80(83.8%)였으며 전체와 저크 단독은 각각 이보다 세 번 더 성공했다(+3.75%포인트). Wilson 구간은 상당 부분 겹치며, 이처럼 작은 횟수 차이는 기술적으로 해석한다.
조건부 비교는 두 사전지식을 구분한다. 미적용 기준에 최소 저크를 더하면 +5.0%포인트지만, 속도–곡률에 최소 저크를 더하면 +1.25%포인트(69/80에서 70/80)다. 미적용 기준에 속도–곡률을 더하면 +3.75%포인트지만, 최소 저크에 더하면 0%포인트(70/80에서 70/80)다. 따라서 속도–곡률은 사전지식 미적용 기준보다 수치상 높았으나, 최소 저크가 이미 있으면 관측된 추가 이익을 제공하지 않았다. 같은 결과라는 사실은 동등성의 증거가 아니다.
2×2 구성요소 비교에서, 다른 구성요소의 두 수준에 걸쳐 각 구성요소의 성공률 차이를 평균하면 기술적 주효과는 최소 저크 +3.125%포인트, 속도–곡률 +1.875%포인트다. 차이의 차이로 구한 상호작용은 −3.75%포인트로, 공동 적용에서 관측된 이득은 각자 얻은 두 이득의 합보다 작다. 이는 집계 비율의 분해일 뿐, 추론적 요인 효과의 추정이나 길항작용의 증명은 아니다.
참고 맥락으로만 제시하면, 과거에 보관된 시스템 비교는 전체 시스템 70/80, 플랫폼에 맞춘 FoAR 기준선[2] 67/80, Diffusion Policy[1] 58/80, 시각 정보만 쓰는 행동 복제 49/80을 기록했다. 그 비교는 동시 수행한 무작위 요인 실험이 아니므로 그림 2와 구성요소 기여 분석에서 제외한다.
IV. 논의
A. 성공 결과가 뒷받침하는 것
결과가 다루는 것은 남아 있는 실험 절차에서의 과제 완료이며 일반적 강건성이나 안전성이 아니다. 최소 저크만 사용해도 속도–곡률 항을 추가하지 않고 가장 높은 관측 성공 횟수와 같았다. 따라서 이는 우월성이 확립된 정책이 아니라 재현 실험을 위한 간결한 후보가 된다. 공동 적용과 둘 다 미적용의 비교는 유용한 정규화 신호가 존재할 가능성과 양립하지만, 구성요소 비교에서는 공동 정규화의 추가 가치가 관측되지 않았다. 음의 상호작용 추정치는 상승효과 주장을 뒷받침하지 않는다.
일반 평활화와의 비교도 중요하다. 세 번의 성공 차이만으로 성능의 원인이 일반적인 정규화가 아니라 인간 운동의 구조에 있다고 확립하기에는 부족하다. 메커니즘을 주장하려면 단지 전체 모델과 두 항을 함께 제거한 제거실험만으로는 부족하며, 궤적 측정과 완전히 명시되고 강도가 일치하는 평활화 대조군이 필요하다.
B. 두 사전지식이 성공에 다르게 작용할 수 있는 이유
최소 저크는 각각의 국소 경로 형상에 특정 속도를 요구하지 않고 예측 가속도의 시간적 변화에 페널티를 준다. 속도–곡률 정규화는 그 대신 국소 기하가 속도를 조직해야 한다고 가정한다. 하나의 해석으로, 접촉에 따른 조정이 중간에 필요한 부드러운 접근을 요구하는 삽입에는 전자가 더 폭넓게 유용할 수 있다. 반면 유용한 궤적 대부분이 직선이거나 곡률보다 접촉이 동작 시점을 결정한다면 후자는 추가 효과가 작을 수 있다.
다른 설명도 가능하다. 두 사전지식이 일부 중복된 편향을 부여할 수 있고, 곡률 항이 0에 가까운 곡률의 처리에 민감할 수 있으며, 선택한 가중치가 모방 충실도와 규칙성 사이의 절충을 다르게 만들 수 있다. 이는 가설이며 측정된 실패 메커니즘이 아니다. 저크, 곡률, 힘, 궤적 품질 또는 접촉 안정성의 결과가 기록되어 있지 않아 이 설명들을 구분할 수 없다. 특히 이 결과는 속도–곡률 정규화가 언제나 효과가 없다거나, 최소 저크가 저크를 실제로 줄였다는 입증된 경로로 성공을 높였다고 보여주지 않는다.
C. 한계와 목표를 정한 재현 실험
본 연구는 로봇 하나, 과제군 하나, 시연 15회, 이진 성공 여부를 다룬 보관 기록 기반의 진단적 예비연구다. 시행 순서, 체크포인트 식별자, 조건별 횟수, 보고되지 않은 정확한 하이퍼파라미터가 없어 재현성이 제한되며, 독립성의 검증, 인과적 기여 분석, 분포 변화별 결론을 내릴 수 없다. 실행 시간, 접촉 안정성 또는 안전성의 향상은 확립되지 않았다. 또한 시연 횟수 한 가지에서만 평가했으므로 데이터 효율의 스케일링 이점도 입증하지 못한다.
목표를 정한 재현 실험에서는 시행별 조건과 결과 기록, 고정된 성공·중단 기준, 정확한 정규화 정의와 가중치, 독립적인 학습 실행을 보존해야 한다. 성공 여부와 함께 실제 실행 저크를 측정하면 제안한 최소 저크 메커니즘을 검증할 수 있다. 경로 곡률과 접촉 단계별 결과를 보존하면 속도–곡률이 언제 도움이 되고 언제 과제와 충돌하는지 검증할 수 있다. 통합 과제 완료를 넘어 주장을 확대하려면 조건별 결과와 안전성에 특화된 결과가 필요하다.
V. 결론
시연 15회, 설정별 실제 로봇 시행 80회의 통합 결과에서 전체 정규화와 최소 저크 단독 정규화는 각각 70회 성공했다. 속도–곡률 단독은 69회, 둘 다 미적용은 66회, 일반 평활화는 67회였다. 최소 저크만으로도 가장 높은 관측 과제 성공과 같았으며, 여기에 속도–곡률을 더해도 관측된 추가 이득은 없었다. 점·구간 비교는 소폭의 기술적 성공 신호를 뒷받침하지만, 상승효과, 생체역학적 특이성, 강건성 또는 안전성을 입증하지 않는다. 따라서 최소 저크는 사전등록한 시행 수준 재현 실험을 위한 더 간단한 후보이다.
데이터·코드, 연구비 및 AI 사용에 관한 공개
데이터 및 코드: 사용한 집계 횟수는 원고에 보고되어 있다. 원래의 시행별 기록과 보고되지 않은 구현 매개변수의 정확한 값은 확인할 수 없다.
연구비 및 이해상충: 본 연구는 특정 연구비를 받지 않았다. 저자들은 본 연구와 관련된 이해상충이 없다고 선언한다.
AI 보조 사용: 언어 편집, 일관성 확인, 보고된 집계 결과의 시각화, 문서 서식에 AI 보조 도구를 사용했다. 과학적 내용과 보고된 결과에 대한 책임은 저자들에게 있다.
참고문헌
- C. Chi, Z. Xu, S. Feng, E. Cousineau, Y. Du, B. Burchfiel, R. Tedrake, and S. Song, “Diffusion Policy: Visuomotor Policy Learning via Action Diffusion,” Robotics: Science and Systems, 2023. [행동 확산을 통한 시각–운동 정책 학습]
- Z. He, H. Fang, J. Chen, H.-S. Fang, and C. Lu, “FoAR: Force-Aware Reactive Policy for Contact-Rich Robotic Manipulation,” IEEE Robotics and Automation Letters, 2025. [접촉이 많은 로봇 조작을 위한 힘 인식 반응형 정책]
- H. Xue, J. Ren, W. Chen, G. Zhang, Y. Fang, G. Gu, H. Xu, and C. Lu, “Reactive Diffusion Policy: Slow-Fast Visual-Tactile Policy Learning for Contact-Rich Manipulation,” Robotics: Science and Systems, 2025. [접촉이 많은 조작을 위한 느린–빠른 시각·촉각 정책 학습]
- H. Sun, S. Liu, Y. Wang, Z. Zhou, S. Wang, H. Yang, J. Sun, and Q. Cao, “Exploring Pose-Guided Imitation Learning for Robotic Precise Insertion,” arXiv:2505.09424, 2025. [로봇 정밀 삽입을 위한 자세 유도 모방학습 탐구]
- J. Yang, Z.-A. Cao, C. Deng, R. Antonova, S. Song, and J. Bohg, “EquiBot: SIM(3)-Equivariant Diffusion Policy for Generalizable and Data Efficient Learning,” Conference on Robot Learning, 2024. [일반화 가능하고 데이터 효율적인 학습을 위한 SIM(3) 등변 확산 정책]
- D. Son and S. Park, “LiPo: A Lightweight Post-optimization Framework for Smoothing Action Chunks Generated by Learned Policies,” arXiv:2506.05165, 2025. [학습된 정책의 행동 청크를 평활화하는 경량 사후 최적화 프레임워크]
- J. Wang, “Frequency-Guided Action Diffusion via Sub-Frequency Manifold Traversal,” arXiv:2605.27919, 2026. [하위 주파수 다양체 순회를 통한 주파수 유도 행동 확산]
- T. Flash and N. Hogan, “The Coordination of Arm Movements: An Experimentally Confirmed Mathematical Model,” Journal of Neuroscience, vol. 5, no. 7, pp. 1688–1703, 1985. [팔 움직임의 협응: 실험으로 확인한 수학적 모델]
- F. Lacquaniti, C. Terzuolo, and P. Viviani, “The Law Relating the Kinematic and Figural Aspects of Drawing Movements,” Acta Psychologica, vol. 54, nos. 1–3, pp. 115–130, 1983. [그리기 움직임의 운동학적 측면과 형상 측면을 연결하는 법칙]
- P. Viviani and T. Flash, “Minimum-Jerk, Two-Thirds Power Law, and Isochrony: Converging Approaches to Movement Planning,” Journal of Experimental Psychology: Human Perception and Performance, vol. 21, no. 1, pp. 32–53, 1995. [최소 저크, 3분의 2 멱법칙, 등시성: 운동 계획을 향한 수렴적 접근]
- N. Hogan, “Impedance Control: An Approach to Manipulation: Part II—Implementation,” Journal of Dynamic Systems, Measurement, and Control, vol. 107, no. 1, pp. 8–16, 1985. [임피던스 제어: 조작을 위한 접근, 2부 구현]
- M. H. Raibert and J. J. Craig, “Hybrid Position/Force Control of Manipulators,” Journal of Dynamic Systems, Measurement, and Control, vol. 103, no. 2, pp. 126–133, 1981. [매니퓰레이터의 혼합 위치·힘 제어]